一、引言
在上一篇文章中我们了解了计算机中数据的表示和运算,那么在本篇文章中我们将继续探索数据在计算机中是如何存储的,现在让我们开始吧!
二、存储器的层次结构
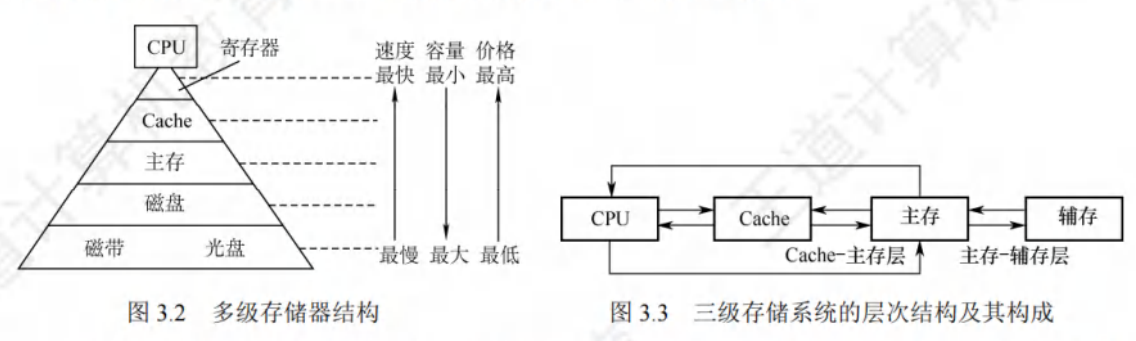
存储器这里的核心思想是trade-off,“想马儿跑但又想马儿少吃草”是不现实的,因此我们必须在这两者中权衡找到一个性能和成本都可以接受的方案,这就是我们的存储器层次结构(如上图所示)。存储器层次结构的核心思想是上层存储器作为下层相邻存储器的高速缓存。
根据不同的教科书,磁盘、磁带和光盘的层级可能不同,可能会将其分为辅存和外存两个层级,也可能同属于一个层级;在这里我们重点强调两个层级:Cache-主存层和主存-辅存层:
- Cache-主存层主要解决的是CPU和主存速度不匹配的问题,主存和Cache之间的数据调度是由硬件自动完成的,对于所有程序员透明
- 主存-辅存层主要解决的是存储系统容量问题,主存和辅存之间的数据调度由硬件和操作系统共同完成,对于应用程序员透明
分类
- 按层级分类:主存(内存)、辅存(外存)、Cache(高速缓冲存储器)
- 按存储介质分类:磁表面存储器、磁芯存储器、半导体存储器(MOS型、双极型)、光存储器
- 按存取方式分类
- 随机存储器(RAM):读写存储单元的时间与其所在的物理位置无关,主要用于主存和Cache,包括静态和动态两种
- 只读存取器(ROM):可随机读取不可写入,通常作为主存的地址域;现在还有派生的类型,保留ROM原本的非易失性,写入速度远远慢于读取速度
- 串行访问存储器
- 顺序存取存储器(SAM):读写存储单元的时间取决于其所在的物理位置
- 直接存取存储器(DAM):结合随机存取和顺序存取的特性,先直接选取信息所在的区域,然后按顺序方式存取
- 相联存储器(CAM):可以按内容访问的存储器,即能够按照内容检索到存储位置并进行读写。注意:相联存储器既可以按内容寻址,也可以按地址寻址。
- 按信息可保存性分类:易失性存储器(如:RAM)、非易失性存储器(如:ROM);
破坏性读出:某个存储单元所存储的信息被读出时,原存储信息被破坏。具有破坏性读出性能的存储器,每次读出操作后,必须紧接一个再生操作恢复被破坏的信息。
性能指标
存储容量
其中,存储字数表示存取器的地址空间大小,字长表示一次存取操作的数据量
单位成本
存储速度
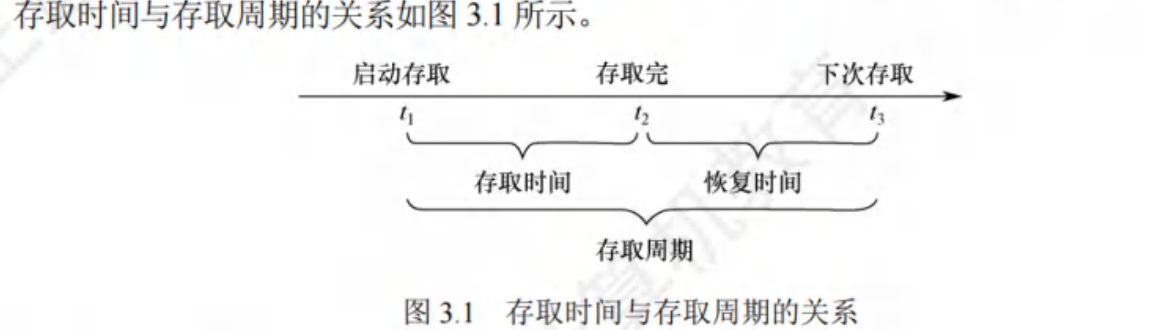
- 存取周期$T_m$:存储器进行一次完整存/取的开销,两次连续独立访问存储器操作之间的最小时间间隔,通常情况下存取周期大于存取时间,如下图所示
- 存取时间$T_a$:存储器操作的时间
- 主存带宽$B_m$:数据传输速率,每秒从主存中进出信息的最大数据量,单位为字/秒、字节/秒、位/秒
一次完整的刷新过程占用一个存取周期
三、主存储器
1.SRAM芯片和DRAM芯片
| 特点\类型 | SRAM(静态RAM) | DRAM(动态RAM) |
|---|---|---|
| 存储元件 | 双稳态触发器 | 电容 |
| 破坏性读出 | 否 | 是 |
| 需要刷新 | 否 | 是 |
| 运行速度 | 快 | 慢 |
| 存储成本 | 高 | 低 |
| 集成度 | 低 | 高 |
| 功耗 | 高 | 低 |
| 易失性 | 是 | 是 |
| 送行列地址 | 同时送 | 分两次送,地址线复用技术 |
| 主要用途 | Cache | 主存 |
刷新通常以行为单位进行,采用读后再生的方式进行。对同一行进行相邻两次刷新的时间间隔为刷新周期,通常取2ms。常用的刷新方式:
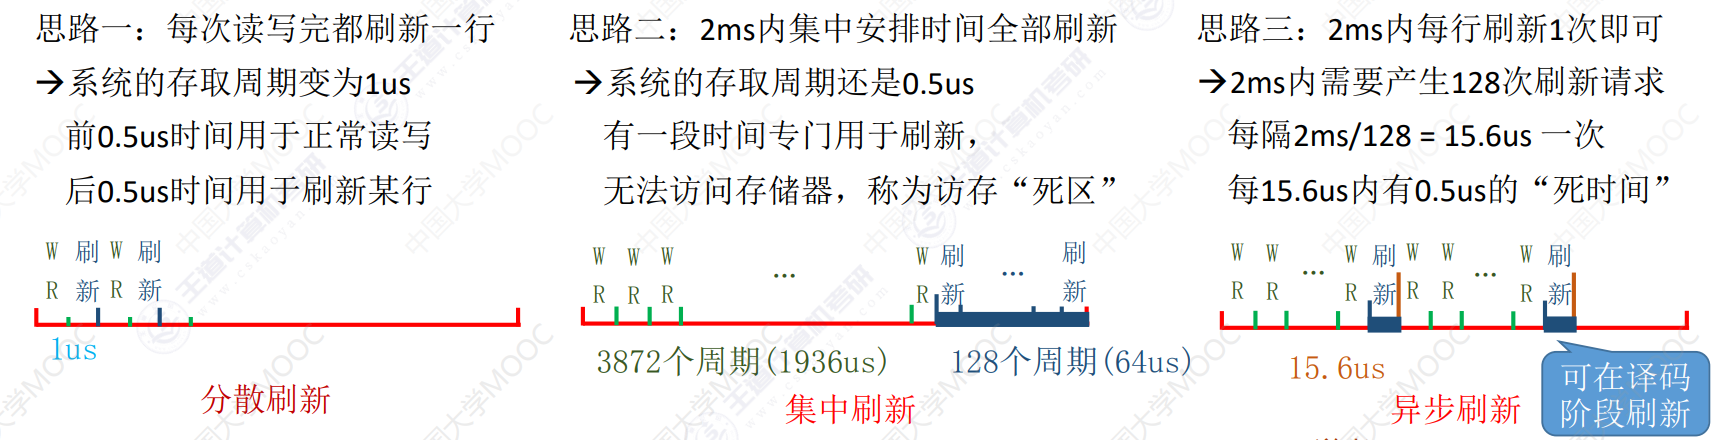
集中刷新:在一个刷新周期内,利用一段固定的时间,依次对存储器的所有行进行逐一再生,在此期间停止对存储器的读/写操作,称为死时间,也称为访存死区。
- 优点:读/写操作期间不受刷新操作的影响
- 缺点:死区无法进行访存
分散刷新:将一个存储器系统的工作周期分成两部分——读/写和刷新,该方法的刷新方式增加了系统的存取周期,即现在的存取周期为两倍的读写周期(刷新的本质是读出重写)。
- 优点:无死区
- 缺点:加长了系统的存取周期
异步刷新:在一个刷新周期内每一行仅刷新一次。记相邻两行之间刷新的时间间隔$t$,即每隔时间$t$产生一次刷新请求
其中,T是刷新周期,r是行数。
SDRAM 同步DRAM芯片,与传统的异步DRAM不同,SDRAM与CPU的数据交换同步于系统的时钟信号。SDRAM支持突发传输方式,即在寻址阶段发送数据单元的首地址,在传输阶段传送多个连续单元的数据,第一次存取的时候给出首地址,同一行的所有数据都被送到行缓冲器,即此后的每一个时钟中都可以连续地从SDRAM输出一个数据。行缓冲器用来缓存指定行中整行的数据,其大小为列数$\mathbf{\times}$位平面数,通常使用SRAM实现。
位平面
计算机系统基础(第二版) (袁春风)
采用三维结构存储阵列的芯片用多个位平面构成存储阵列,不同位平面在同一行、列交叉点上的多位构成一个存储字。
即,位平面数=存储字数
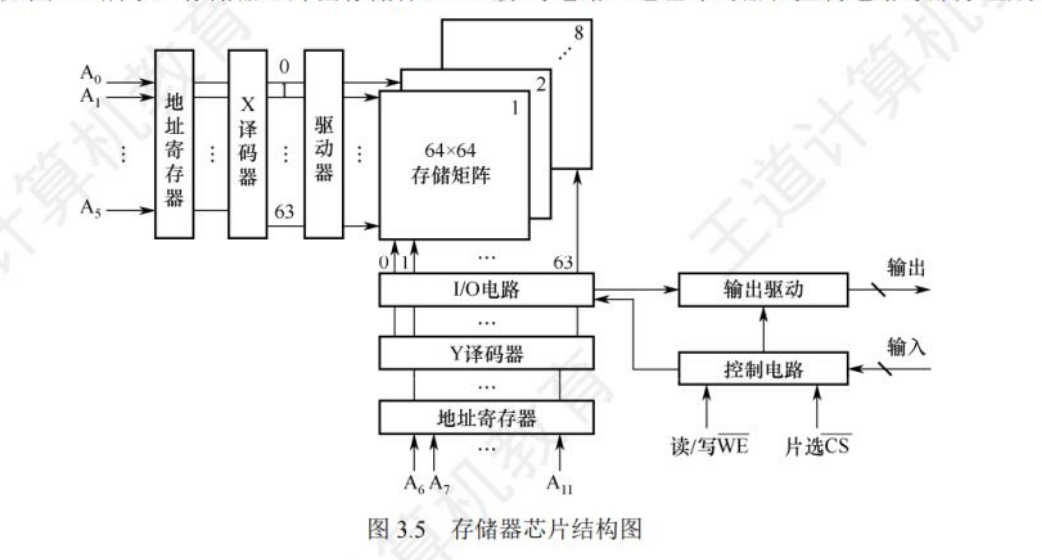
如上图所示,为了工程上的易实现性,我们将存储单元按照二维的方式排列,采用行列地址来减少选通线的数量。
DRAM地址线复用技术 由于DRAM芯片的容量较大、地址位数较多,故为了减少芯片的地址引脚数,通常采用地址线复用技术——行地址、列地址分两次先后通过相同的地址线进行传输。
DRAM芯片行、列数优化原则
假定DRAM的存储容量为$2^n\times b$位,行数为$r$、列数为$c$,则有$r\times c=2^n$。
- 由于DRAM采用行刷新,为了减小刷新开销,存储阵列的行数应该尽可能小,即$r\le c$
- 同时,DRAM采用地址线复用技术,为了使得地址线尽可能的少,存储阵列的行列数应该尽可能相同,即$|r-c|$尽可能小
2.只读存储器
上一小节中我们整理了RAM的相关知识点,RAM属于易失性存储器,即断电后数据不会被保存在硬件中;在本小节中我们继续整理非易失性存储器——ROM。
MROM(Mask Read-Only Memory)掩模式只读存储器
- 优点:可靠性高、集成度高、价格便宜
- 缺点:灵活性差
PROM(Programmable Read-Only Memory)可编程只读存储器
- 优点:可编程
- 缺点:一次写入
EPROM(Erasable Programmable Read-Only Memory)可擦除可编程只读存储器
- 优点:可多次写入
- 缺点:编程次数有限,写入时间过长
- UVEPROM(ultraviolet rays)紫外线擦除,擦除所有信息
- EEPROM(electrically)电擦除,擦除特定的字
Flash存储器——闪存
在EEPROM上发展而来,非易失性存储器,可进行多次快速的擦除重写。先擦除后写入,”写“比“读”慢
U盘是基于Flash存储器技术的一种存储器,因此U盘是ROM。
固态硬盘(SSD,Solid State Drives)
控制单元+flash芯片,可进行多次快速的擦除重写,速度快、功耗低,但价格高
3.主存储器的结构
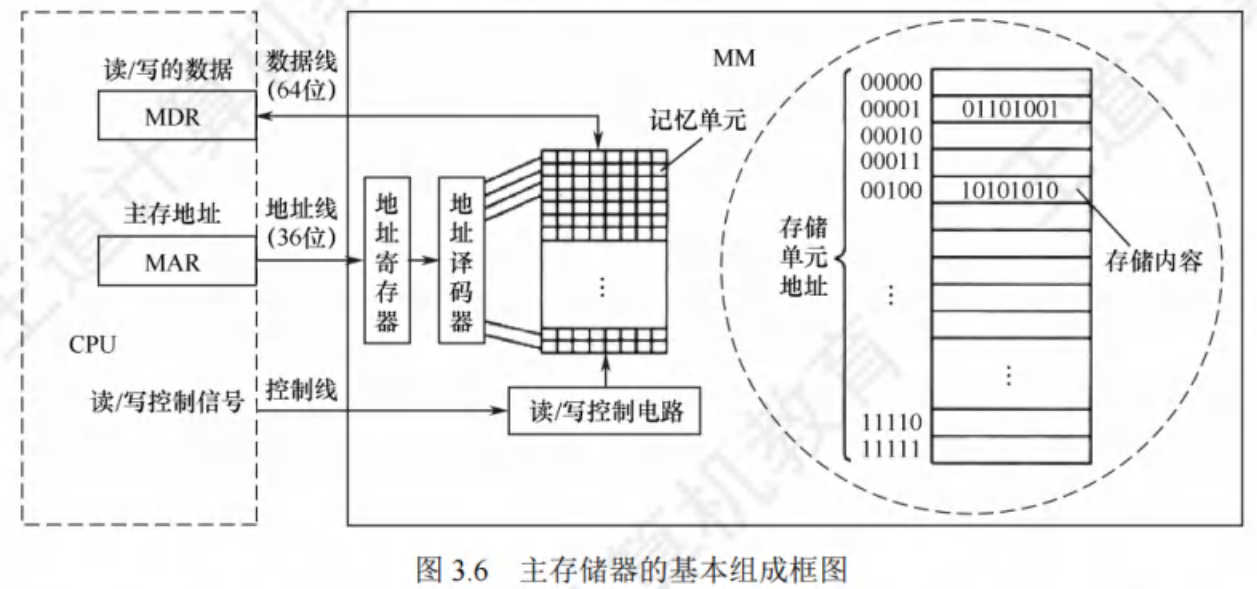
在这里我们回顾几个基本概念:
| MAR | MDR | |
|---|---|---|
| 名称 | Memory Address Register,存储器地址寄存器 | Memory Data Register,存储器数据寄存器 |
| 内容 | 将要访问的存储单元的地址 | 从存储单元中读取的数据;将要写入存储单元的数据 |
| 位数含义 | 假设MAR的位数为n,则存储器芯片存储单元的个数为$2^n$ | 存储字长 |
| 位数 | 地址线 | 数据线 |
存储体$\supset$存储单元【对应于存储字】$\supset$存储元件(记忆单元)【对应于位】
存储容量
其中,存储字数表示存取器的地址空间大小,字长表示一次存取操作的数据量;若已知地址线和数据线分别为$m$和$n$根,那么存储容量为$2^m\times n$位。
4.双端口RAM和多模块存储器
1‘ 双端口RAM
双端口RAM存在的意义是优化多核CPU访问一根内存条的速度,使得一个RAM可以同时被两个CPU访问:
- 两个端口同时对不同地址单元进行存取✔
- 两个端口同时对同一地址单元进行读取数据✔
- 两个端口同时对同一地址单元进行写入数据✖
- 两个端口同时对同一地址单元进行数据写入和读取✖
操作系统”读者-写者问题“
2‘ 单体多字存储器
多模块存储器是一种空间并行技术。单体多字系统中,每个存储单元存储m个字,一次访问可并行读取m个字,因此总线宽度也是m个字。
缺点 需要将数据连续存放
3‘ 多体并行存储器
与单体多字存储器类似,但是每个模块有独立的读/写控制电路、地址寄存器和数据寄存器,同时每个模块具有相同的容量和存取速度。
- 高位交叉编址(顺序编址)
高位地址表示模块号(体号),低位地址表示模块内地址。根据这种编址方式我们可以发现,在访问一个连续主存块时,我们总是先在一个模块的内部访问,在访问完该模块后再顺序访问下一个模块,各个模块不能被并行访问,无法提高吞吐率。
- 低位交叉编址
低位地址表示模块号,高位地址表示模块内地址。如果每个模块按照“模m”交叉编址,那么模块号=单元地址%m。
交叉编址存储器可以采用轮流启动或同时启动两种方式:
轮流启动
每个模块一次读/写的位数恰好等于总线位数。
若记模块的存取周期为$T$,存取时间(或总线传输周期,均表示CPU读取瓶颈)为$r$,那么存储器模块数应该大于等于$T/r$,而为了更好的利用模块资源应该取等号。
在理想条件下,连续存取$m$个字所需时间$t=T+(m-1)\times r$,相较于一般存储器$t^{\prime}=m\times T$而言有了很大提升。
同时启动
所有模块一次并行读/写的位数恰好等于总线位数。忽略地址低位的体号,不进行选体,直接根据高位地址的存储单元号同时将$m$个存储体里符合的存储字读取出来,即在一个存取周期内可以读出$m$个存储字,因此
类似于位扩展
5.主存储器容量的扩展
单个芯片容量有限,因此内存实际上是由多个芯片集成的,回顾存储容量的计算(这个公式在这一章已经出现了好几次了):
通过以上公式,我们很容易想到主存储器容量的扩展的两个思路:
- 增加存储字数——增加存储单元的数量
- 增加存储字长
分别对应于接下来的两个小节:字扩展法和位扩展法。
1‘ 位扩展法
位扩展法,对字长进行扩展,即增加存储字长,适用于CPU的数据线数量大于存储芯片的数据位数。
2‘ 字扩展法
字扩展法,对存储单元的数量进行扩展,适用于CPU的地址线数量大于存储芯片的地址线位数,高位作为片选信号。
3‘ 字位扩展法
结合字扩展法和位扩展法
6.主存储器与CPU的连接
主要需要考虑以下几个方面:
- 地址线
- 数据线
- 读写命令线
- 片选线(线选法,还有利用译码器来进行片选的方式)
另外还需要考虑选择合适的存储芯片:
- ROM:存放系统程序、标准子程序和各类常数
- RAM:用户编程
四、外存(辅存)
磁表面存储器——磁性材料作为载体,每次读写都是1bit,且读写不可同时进行【串行】;如:磁盘、磁带、磁鼓等。
优点
- 存储容量大,位价格低
- 记录介质可重复使用
- 记录信息可长期保存而不丢失,可脱机存档
- 非破坏性读出
缺点
- 存取速度慢
- 机械结构复杂
- 工作环境要求高
1.磁盘存储器
省流总结:每一条磁道上的存储容量相同,即外圈和内圈的容量是一致的,因此磁盘的存储容量受限于最内圈的最大记录数。
磁盘存储器=磁盘驱动器+磁盘控制器+盘片
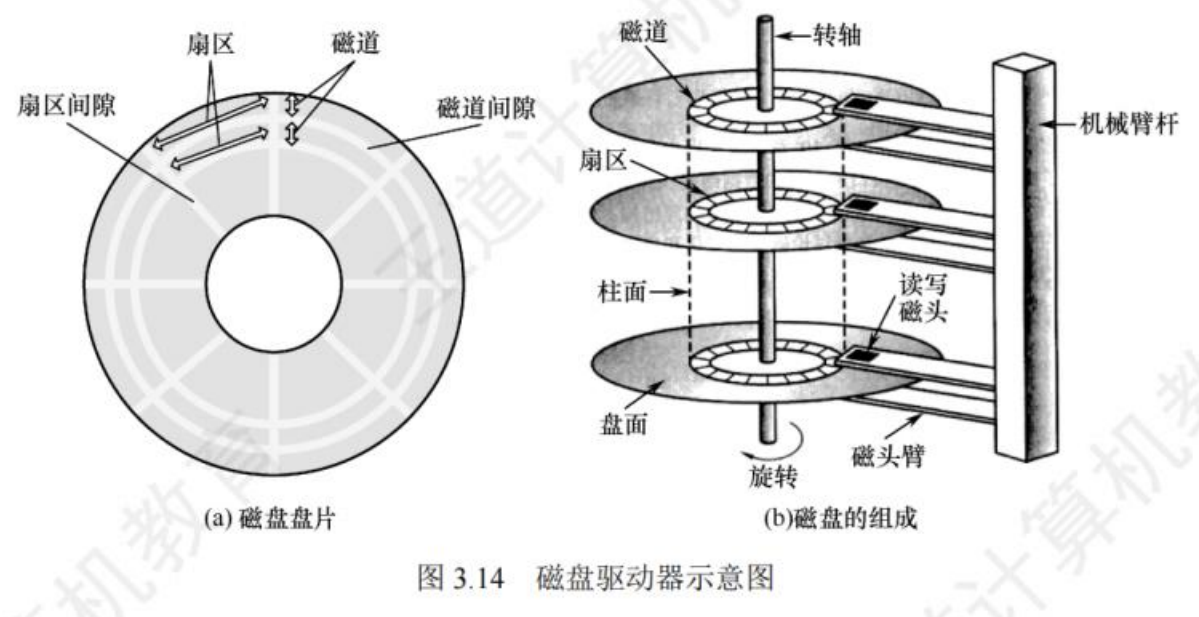
关于存储区域的一些基本概念:
- 磁头数:记录面数,盘片两面均可作为记录面
- 柱面数:实际上就是一个盘片上面的磁道数,因为实际的磁盘是由多个盘片组成的,相同的磁道形成一个柱面
- 扇区数:扇区又称块,表示每个磁道被分为多少个部分,扇区是依靠圆心角划分的,因此内外圈磁道的扇区数相同,并且每一个扇区内的磁道其存储位数相同
磁盘地址结构 |驱动器号|柱面号(磁道号)|盘面号(磁头号)|扇区号(块号)|
实际上就是磁盘的一个工作流程,磁盘是怎么取到我们最终想要的数据的一个过程——从宏观到微观(不严谨描述)
磁盘的性能指标
提到性能就是两个角度:时间和空间
记录密度
密度:单位空间内的某个物质成分含量
- 位密度:磁道单位长度上能够记录的二进制数据位数
- 道密度:磁盘半径方向单位长度上的磁道数
- 面密度:位密度和道密度的乘积
容量
商家和用户的错位
商家宣传的容量——非格式化容量
用户手上实际的容量——格式化容量
非格式化容量:磁记录表面可利用的的磁化单元总数
格式化容量:按照某种记录格式所能存储的信息总量
存取时间=寻道时间(磁头移动到目的磁道的时间)+旋转延迟时间(磁头定位到目的扇区的时间)+传输时间(数据传输时间)
由于寻道远近和扇区远近不同,因此取平均值:即一半
数据传输速率:单位时间内磁盘存储器向主机传输数据的字节数
独立冗余磁盘阵列(RAID)——存储性能、可靠性和安全性
| 分级 | 技术 |
|---|---|
| RAID0 | 无冗余、无校验,条带化技术——并行读写:将连续的数据块交替存放在不同的物理磁盘扇区中;注意:无容错能力 |
| RAID1 | 镜像磁盘阵列——两个磁盘互为备份 |
| RAID2 | 纠错的海明码 |
| RAID3 | 位交叉奇偶校验 |
| RAID4 | 块交叉奇偶校验 |
| RAID5 | 无独立校验的奇偶校验 |
| 技术 | 目的 |
|---|---|
| 多个磁盘 | 提高传输速率 |
| 并行存取 | 提高吞吐量 |
| 镜像 | 安全可靠 |
| 数据校验 | 容错 |
2.固态硬盘(SSD)
固态硬盘基于闪存技术(EEPROM),也就是说它是ROM;与传统机械硬盘的对应关系:
| 磁盘 | SSD |
|---|---|
| 磁盘驱动器 | 闪存芯片 |
| 磁盘控制器 | 闪存翻译层(负责翻译逻辑块号,找到对应的页) |
| 盘片(磁表面存储器) | 闪存(EEPROM) |
| 磁道 | 块 |
| 扇区 | 页 |
磁盘是以扇区为单位进行读写操作的,而SSD是以页为单位进行读写操作的。对于SSD而言,以块为单位进行擦除,擦干净的块中每页都可以进行一次写入,无限次读出。
优点
- 随机访问(注意:磁盘是直接存取存取器,结合顺序存取存储器和随机存储器的特点)
- 无机械噪声和振动
- 能耗低
- 抗震性好
- 安全性高
磨损均衡
引入原因:部分闪存芯片的损坏会导致整个SSD损坏
思想:让被擦除次数较多的存储块承担更多读操作
分类
- 动态磨损均衡:写入数据时选择更新的块
- 静态磨损均衡:SSD监测并自动分配【更先进】
五、高速缓冲存储器——Cache
1.局部性原理
局部性原理与其说是一个程序的原理,不如说程序员在早期编程经验中总结出来的一条经验规律,然后“传承”给后来的程序员并且要求他们遵守;或者说算是编程标准化。
时间局部性 近期使用的数据可能马上还要用
空间局部性 近期使用的数据附近的数据可能马上要用
2.Cache基本概念
Cache即为高速缓冲存储器,其存在的目的是解决CPU和内存的速度矛盾;其缓冲的思路正是局部性原理,在此基础上我们有以下问题:
- Cache与内存之间的映射关系
- Cache替换策略
- Cache与内存内容的一致性问题
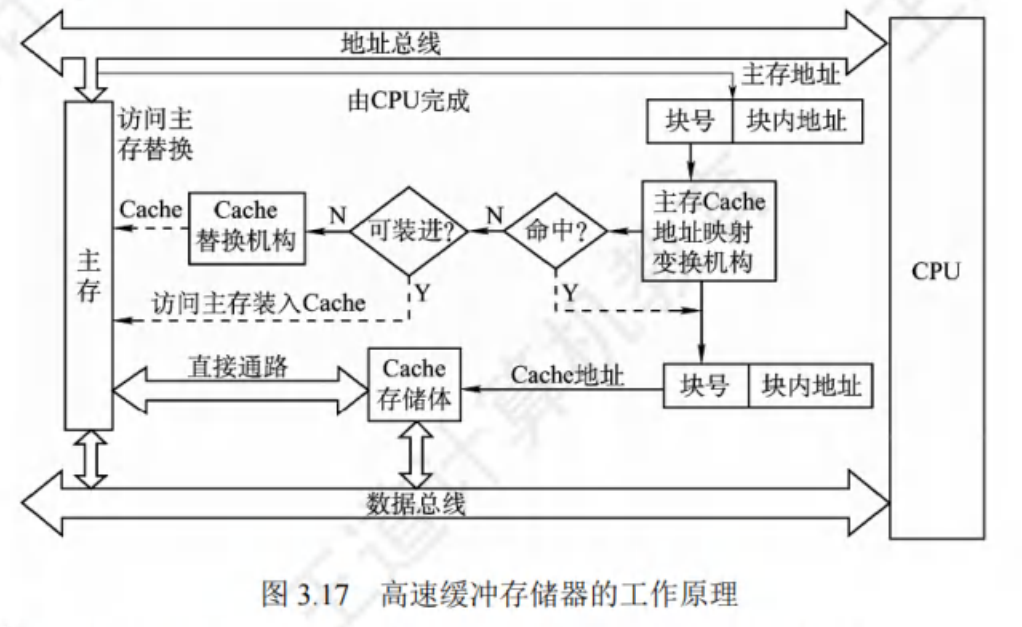
Cache块 也称Cache行
命中 若CPU要访问的数据能够直接从Cache中获取则称命中,否则为未命中
命中率 CPU将要访问的数据已经在Cache中的比例
主存块 也称页、页框、页面
访问策略
同时访问:即同时访问Cache和内存,此时平均访问时间为
$H$为命中率,$t_c$为访问Cache的时间,$t_m$为访问内存的时间
依次访问:即先访问Cache,若未命中再访问内存,此时平均访问时间为
$H$为命中率,$t_c$为访问Cache的时间,$t_m$为访问内存的时间
3.Cache和主存(内存)的映射方式
第一个问题:Cache与内存之间的映射关系
这个问题的产生原因是Cache是由SRAM构成的,而SRAM的成本较高,因此Cache的容量必然远远小于内存,这也很容易理解,如果成本一样容量一样,那直接作为内存岂不美哉?存储器层次结构也就没有必要存在了,说到底还是一个TRADE-OFF。
Cache中的内容是主存的副本,那么我们需要有标记位来标记Cache中的内容对应的是主存中的哪一个地址中的内容,同时我们还需要一个有效位来标记Cache行中内容是否有效。
注意:
主存块大小=Cache块大小,因为Cache与主存之间的数据交换是以块为单位的;另外CPU与主存或Cache的数据交换是以字为单位的。
1‘ 直接映射(直相联)
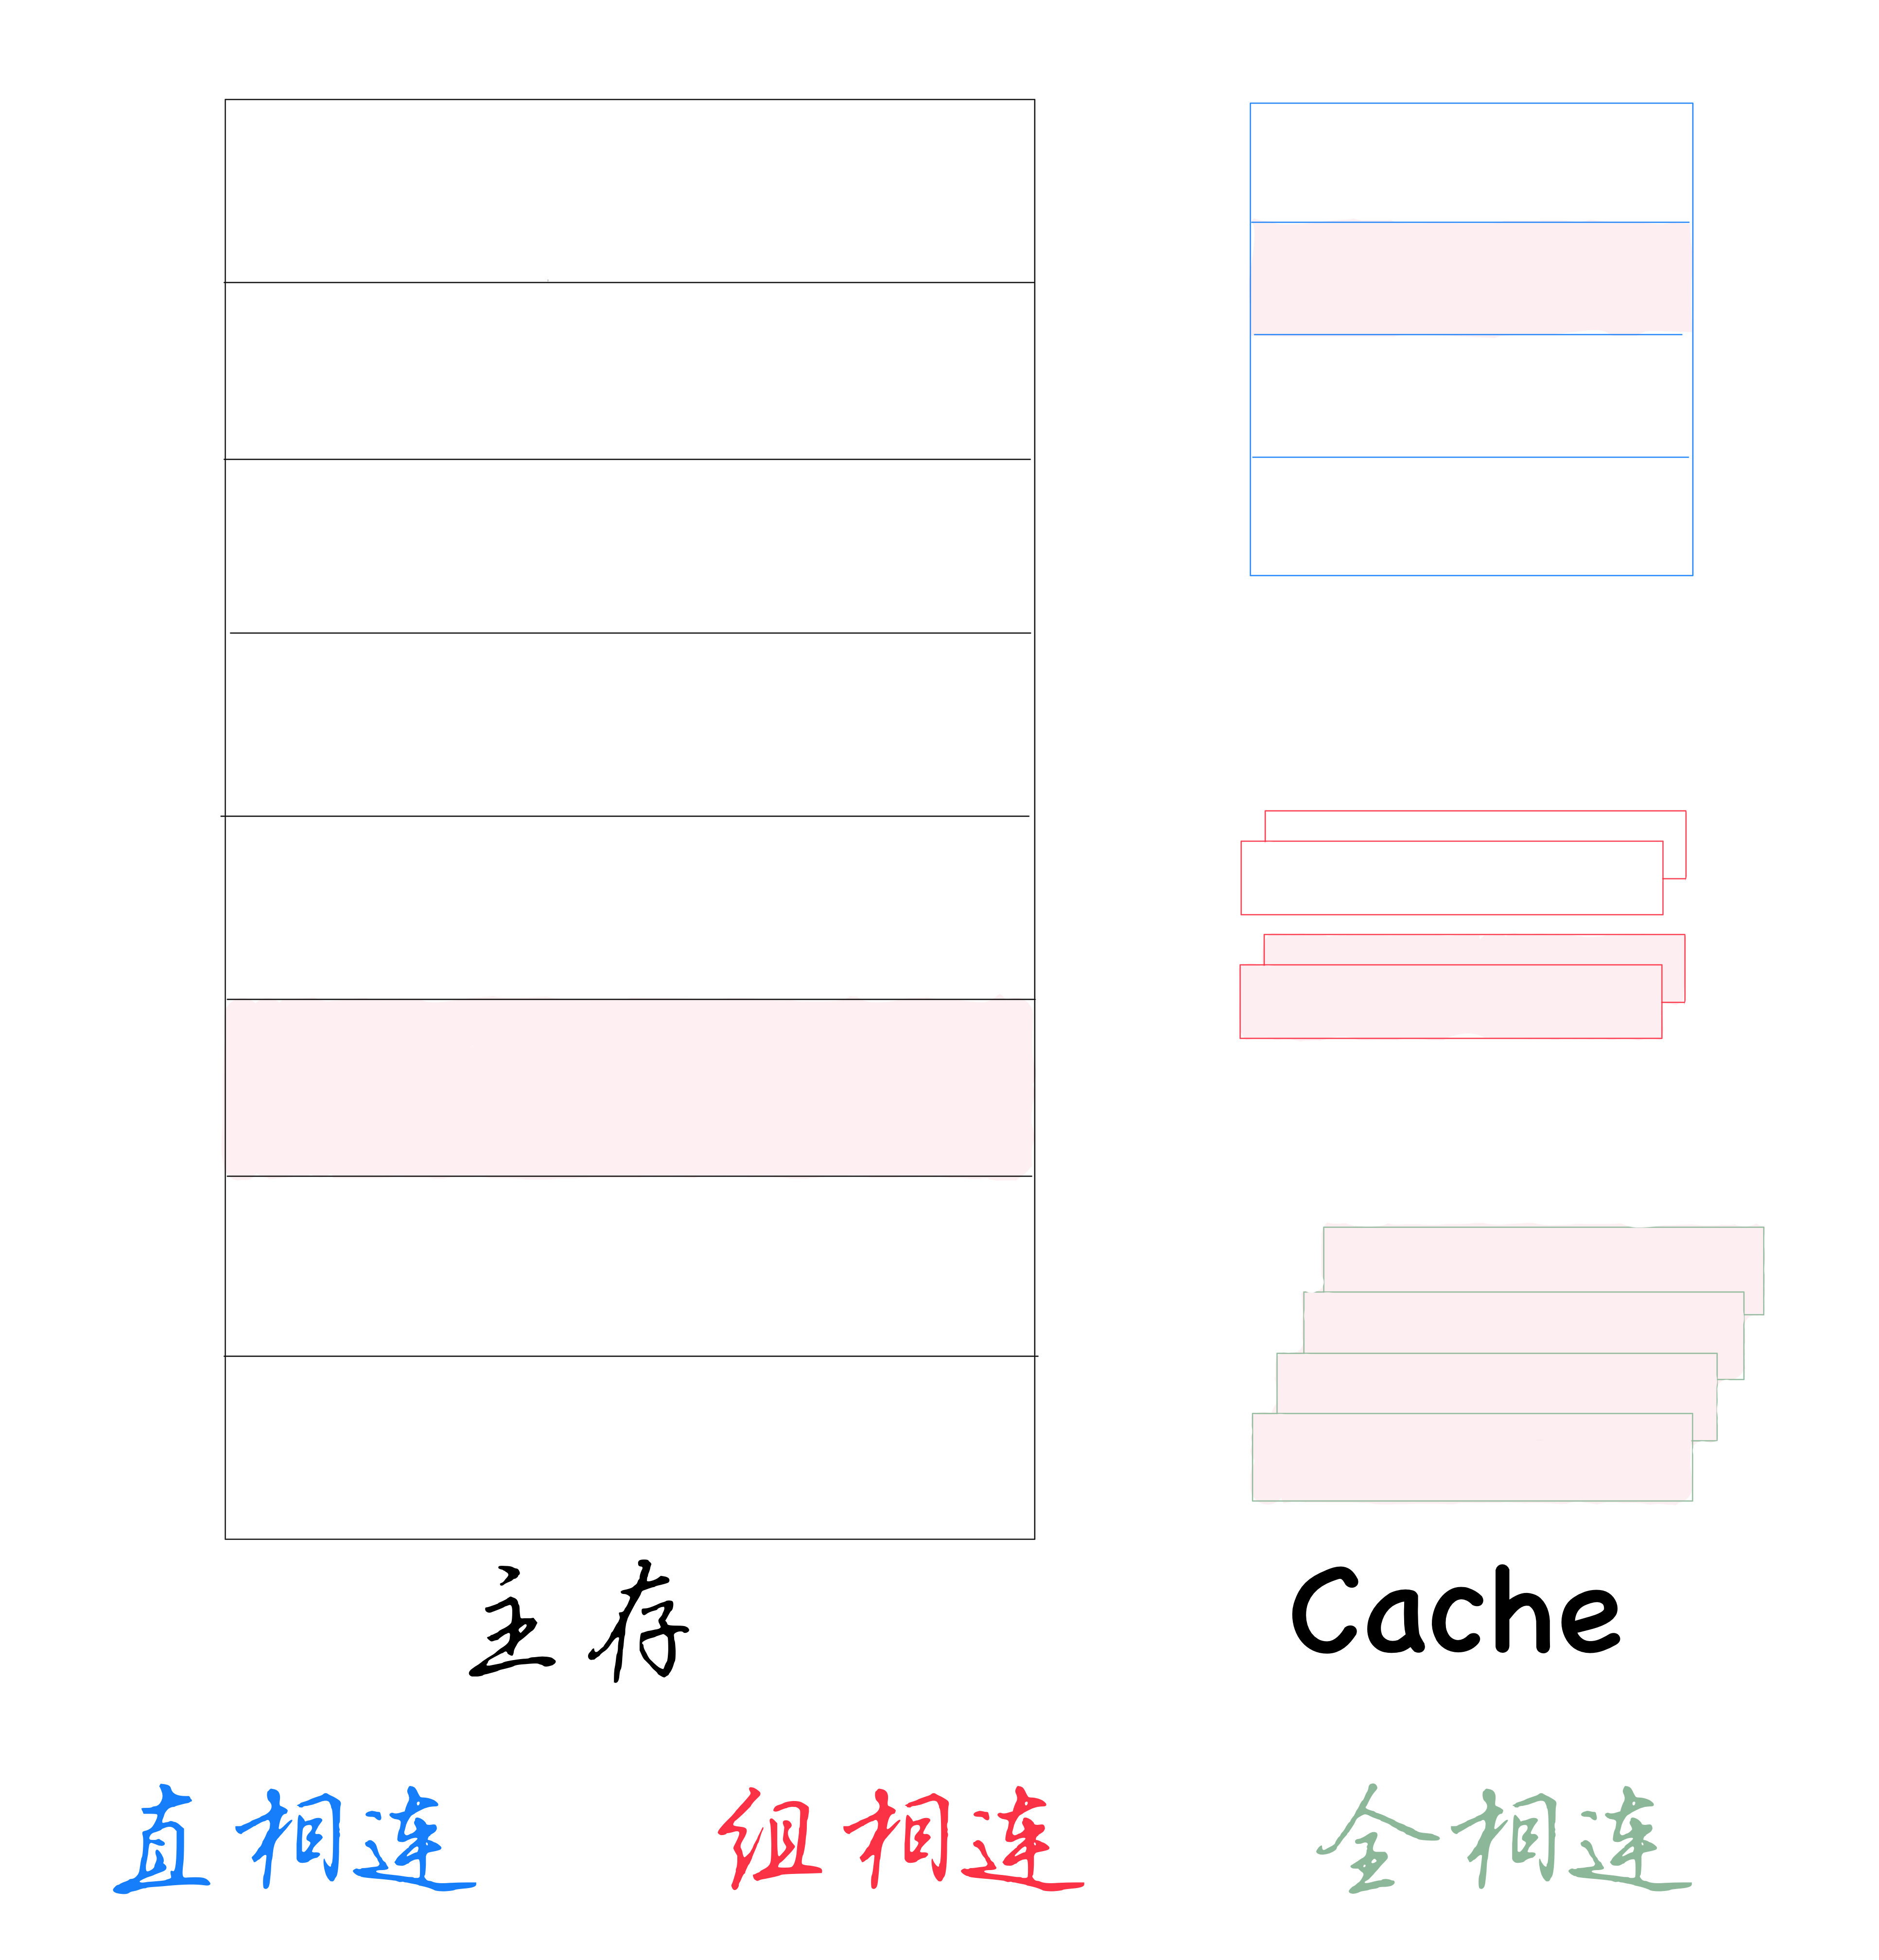
主存中的每一块只能装入Cache中的唯一位置,若该位置已有内容,则发生冲突,原先的内容将会被无条件替换。关系式
由于无论是内存还是Cache的硬件设计要求其容量均为2的整数次幂,实际上我们可以根据地址结构来直接获得我们想要的信息。
假设主存地址空间大小(容量)为$2^nB$,按字节($1B=8bits$)编址,同时将其分为$2^m$块,Cache总行数为$2^c$,那么有以下结构:
1 | +------------------------------+--------------------+ |
2‘ 全相联映射
主存中的每一块只能装入Cache中的任一位置,有以下结构:
1 | +------------------------------+--------------------+ |
全相联映射优点
- Cache的冲突概率低,只要存在空闲的Cache就不会发生冲突
- 空间利用率高
- 命中率高
缺点
- 标记的比较速度慢,目标地址的高$m$位(即$log_2主存块数$)需要与Cache每一行的标记比较
- 实现成本高,通常需要借用相联存储器(既可以按照地址寻址,也可以按照内容寻址)
3‘ 组相联映射
将Cache分成大小相同的$Q$组,即$Q=\frac{Cache总行数}{一组中Cache的行数}$,主存中的每一块可以放入固定组中的任意一行,即组间直接映射,组内全相联映射,关系式
由于无论是内存还是Cache的硬件设计要求其容量均为2的整数次幂,实际上我们可以根据地址结构来直接获得我们想要的信息。
假设主存地址空间大小(容量)为$2^nB$,按字节($1B=8bits$)编址,同时将其分为$2^m$块,Cache组数为$2^q$,那么有以下结构:
1 | +------------------------------+--------------------+ |
当$Q=1$时,组相联映射实际上就是全相联映射;当$Q=Cache总行数$时,组相联映射实际上就是直接相联映射,因此组相联映射是TRADE-OFF的产物,即直接映射和全相联映射的折中。
对于组相联映射,每组中有$\mathbf{r}$个Cache行则称该映射为$\mathbf{r}$路组相联映射。
小结
- 直接映射的命中率最低,全相联映射的命中率最高
- 直接映射的判断开销最小、耗时最短,全相联映射的判断开销最大、耗时最长
- 直接映射的标记位占额外空间开销最小,全相联映射的标记位占额外空间开销最大
4.Cache替换算法
可参考OS中的页替换算法
注意 只有全相联映射和组相联映射需要替换算法,因为对于直接映射而言,发生冲突的时候不需要考虑直接替换即可。
- RAND算法(随机算法):随机替换,毫无规律,实现简单,效果不稳定【未考虑局部性原理】
- FIFO算法(先进先出算法):同样未考虑局部性原理
- LRU算法(最近最少使用算法):即将最近最少使用的Cache块替换出去,实现上是借助一个计数器(也称LRU替换位)来记录主存块的使用情况,具体的计数规律如下:
- 命中,命中行计数器清零,小于该数的计数器+1
- 未命中且还有空闲行,新装入行计数器置0,其余+1
- 未命中且没有空闲行,替换行计数器清零,其余+1
- LFU算法(最不经常使用算法):将一段时间内访问次数最少的Cache块替换出去,同样使用计数器
抖动 频繁的换入换出现象——刚换出的块很快又被调入
5.Cache一致性问题
问题原因 Cache与主存不是相割裂的存在,Cache中的内容本质上是主存的一个副本。我们的CPU优先会在这个副本上进行操作,因为快;但是这就导致了一个问题,我们有可能只修改了Cache中的内容,但是还未改变主存中的内容。从我们的描述中很容易发现这个一致性问题出现在写操作当中。
计组这里好像考的没有那么深入,记得体系结构课程中好像还有更复杂一些的东西,如果后续有时间或者我遇到了相关的题,我再回来更新。
写操作命中 即在进行写操作时,Cache块中有我们要更新的内容副本,此时我们很容易有两种思路:
同时更新Cache和主存,保证两者内容时刻一致,即全写法(直写法,write-through)。
似乎还有将其称为写穿透、写直达、写直通的
采用这个方法的同时我们可以使用写缓冲(先进先出的队列、SRAM)来平衡速度不匹配的问题。
先更新Cache中的内容,在这一个Cache行被替换时,写回主存,即回写法(写回法,write-back)。该方法减少了访存次数,同时为了标记一致性,给Cache行增添一个修改位(脏位)
写操作未命中 这个时候很显然我们是直接修改主存,但是我们仍然有两个思路,这是针对于修改后的主存块是否装入Cache的考虑:
- 写分配法(write-allocate) 更新主存,并将更新块调入Cache,试图利用空间局部性。
- 非写分配法(not-write-allocate) 仅更新主存,不调入。
分离指令Cache和数据Cache、多级Cache
六、虚拟存储器
结合OS