一、引言
在本篇文章中我们将会探讨计算机中的数据表示,CS50x 2024 中Malan教授利用电灯泡简单的向学生们说明了原码二进制的数据表示方法,然而二进制不仅仅这么简单,让我们一起来探索一下吧~
【题外话】稍微吐槽一下字数统计和阅读时长估计,有点不太准,当个装饰好了。
二、进制的转换
常用的进位计数法包括十进制(Decimal)、二进制(Binary)、八进制(Octal)和十六进制(Hexadecimal),进位计数法由数码$K_i$(取值可以是$0,1\dots r-1$中的任意一个)和位权$r^i$(其中$r$是基数,即$r$进制)组成:
1.二进制转八进制/十六进制
二进制整数 从小数点开始向左数,每3个数为一组(八进制)或每4个数为一组(十六进制),在数的最左边空位补0,将其转换为对应的八进制或十六进制数码
二进制小数 从小数点开始向右数,每3个数为一组(八进制)或每4个数为一组(十六进制),在数的最右边空位补0,将其转换为对应的八进制或十六进制数码
2.八进制/十六进制转二进制
对于八进制/十六进制数而言,将每一位数码改写为3位/4位二进制数即可,必要时可省略整数部分最高位或小数部分最低位的0
八进制与十六进制的转换可借助二进制作为中间桥梁
3.R进制转十进制
按权展开相加法 根据进位计数法的定义,将R进制数的数码与其位权相乘后相加之和即为对应的十进制数
4.十进制转R进制
十进制转R进制采用基数乘除法,具体包括除基取余法和乘基取整法
整数部分 除基取余,倒排余数
小数部分 乘基取整
【补充说明】
在计算机中,小数是离散的,即不是所有的十进制小数都可以用二进制来表示,如0.3;归根结底还是位数有限。
三、定点数的编码表示
真值,即我们日常生活中所书写的带有正(+)负(-)号的数字。然而,还记得吗?计算机的语言是二进制,它所能识别的仅仅只有两种符号——0和1,因此我们需要一种新的方式来表示真值,即机器数。机器数将数据的符号数字化,通常情况下用“0”表示“正”、“1”表示“负”。根据小数点的位置是否固定,计算机中有两种数据格式:定点表示法和浮点表示法。
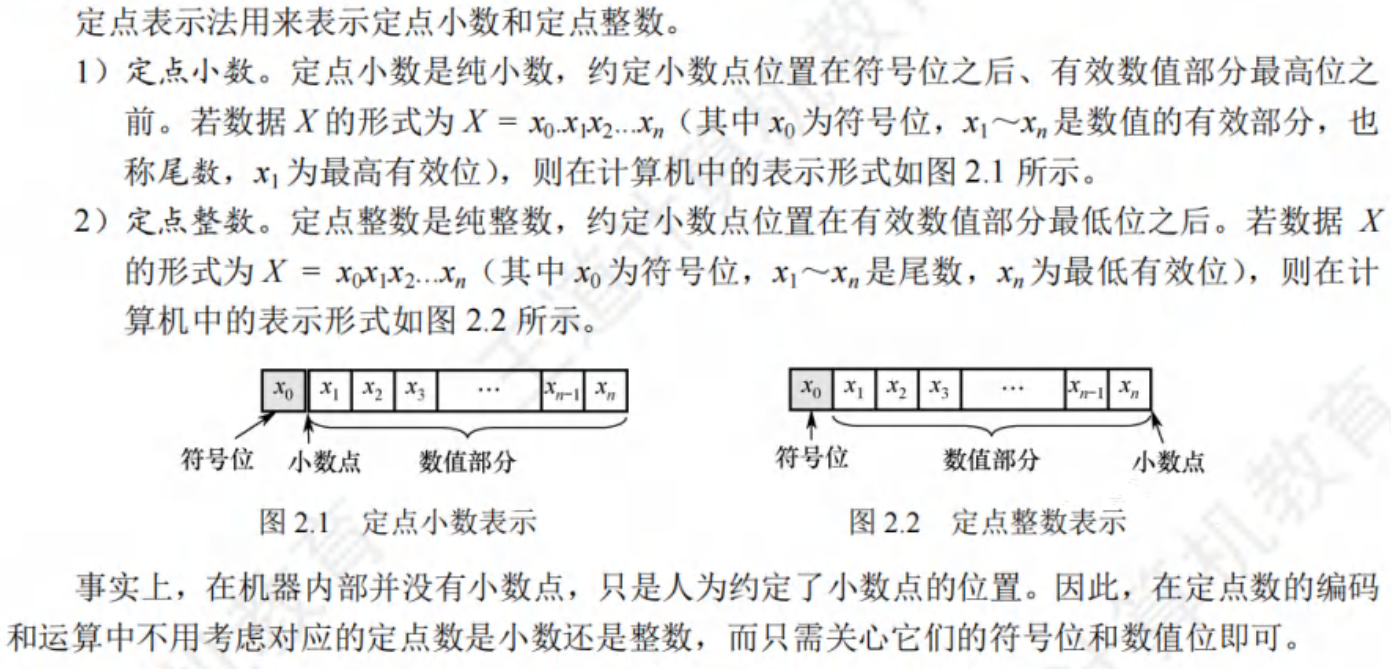
1.原码
用机器数的最高位作为符号位,用“0”表示“正”、“1”表示“负”,有定义式:
原码整数表示范围为$-(2^n-1)\le x\le2^n-1$(关于原点对称),“0”有正负两种表示。
2.补码
【题外话】在看这一部分的时候我总是想知道为什么这么设计,是谁想到的这种设计方法,有时候一开始探究背后的事情就不知不觉地钻牛角尖。直到现在我也没有一个确切的证据去说明是谁明确地提出了补码的概念,接下来我尝试解释一下补码的作用(以这个话题中最常用的钟表为例子)。这里我贴出两个链接:
这篇文章用比较通俗的方式去解释了补码的合理性,语言比较浅显,术语相对较少,并且辅以简单的例子来说明。
这篇文章从数学的角度说明了补码的合理性,很遗憾,我的离散数学并没有学好,所以虽然我想要一个严谨的说明,但是数学基础并不支持我这样做,因此我不能判断这篇文章的正确性。
原码与真值的对应关系很简单、直观,但是加减运算的逻辑对于计算机而言比较复杂:需要先判断两个数的符号,对于不同符号数的加法(同符号数的减法)而言,要先比较两个数的绝对值大小,然后用绝对值大的数减绝对值小的数,最后选择适合的符号。为了更方便的进行加减运算,我们引入了补码的概念。
在介绍补码的概念之前,我们先补充一点数学上的小知识:
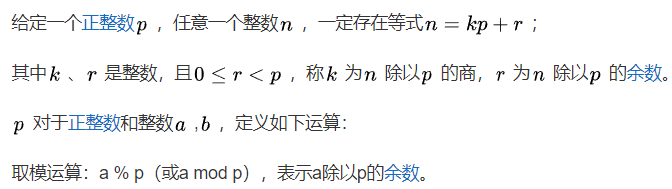
同余 正整数$a$,$b$对$p$取模,它们的余数相同,记做 $a \equiv b\ \%\ p$或者$a \equiv b\ (mod\ p)$
【题外话】顺带补充一个取模和取余的区别:模运算的概念和性质-CSDN博客
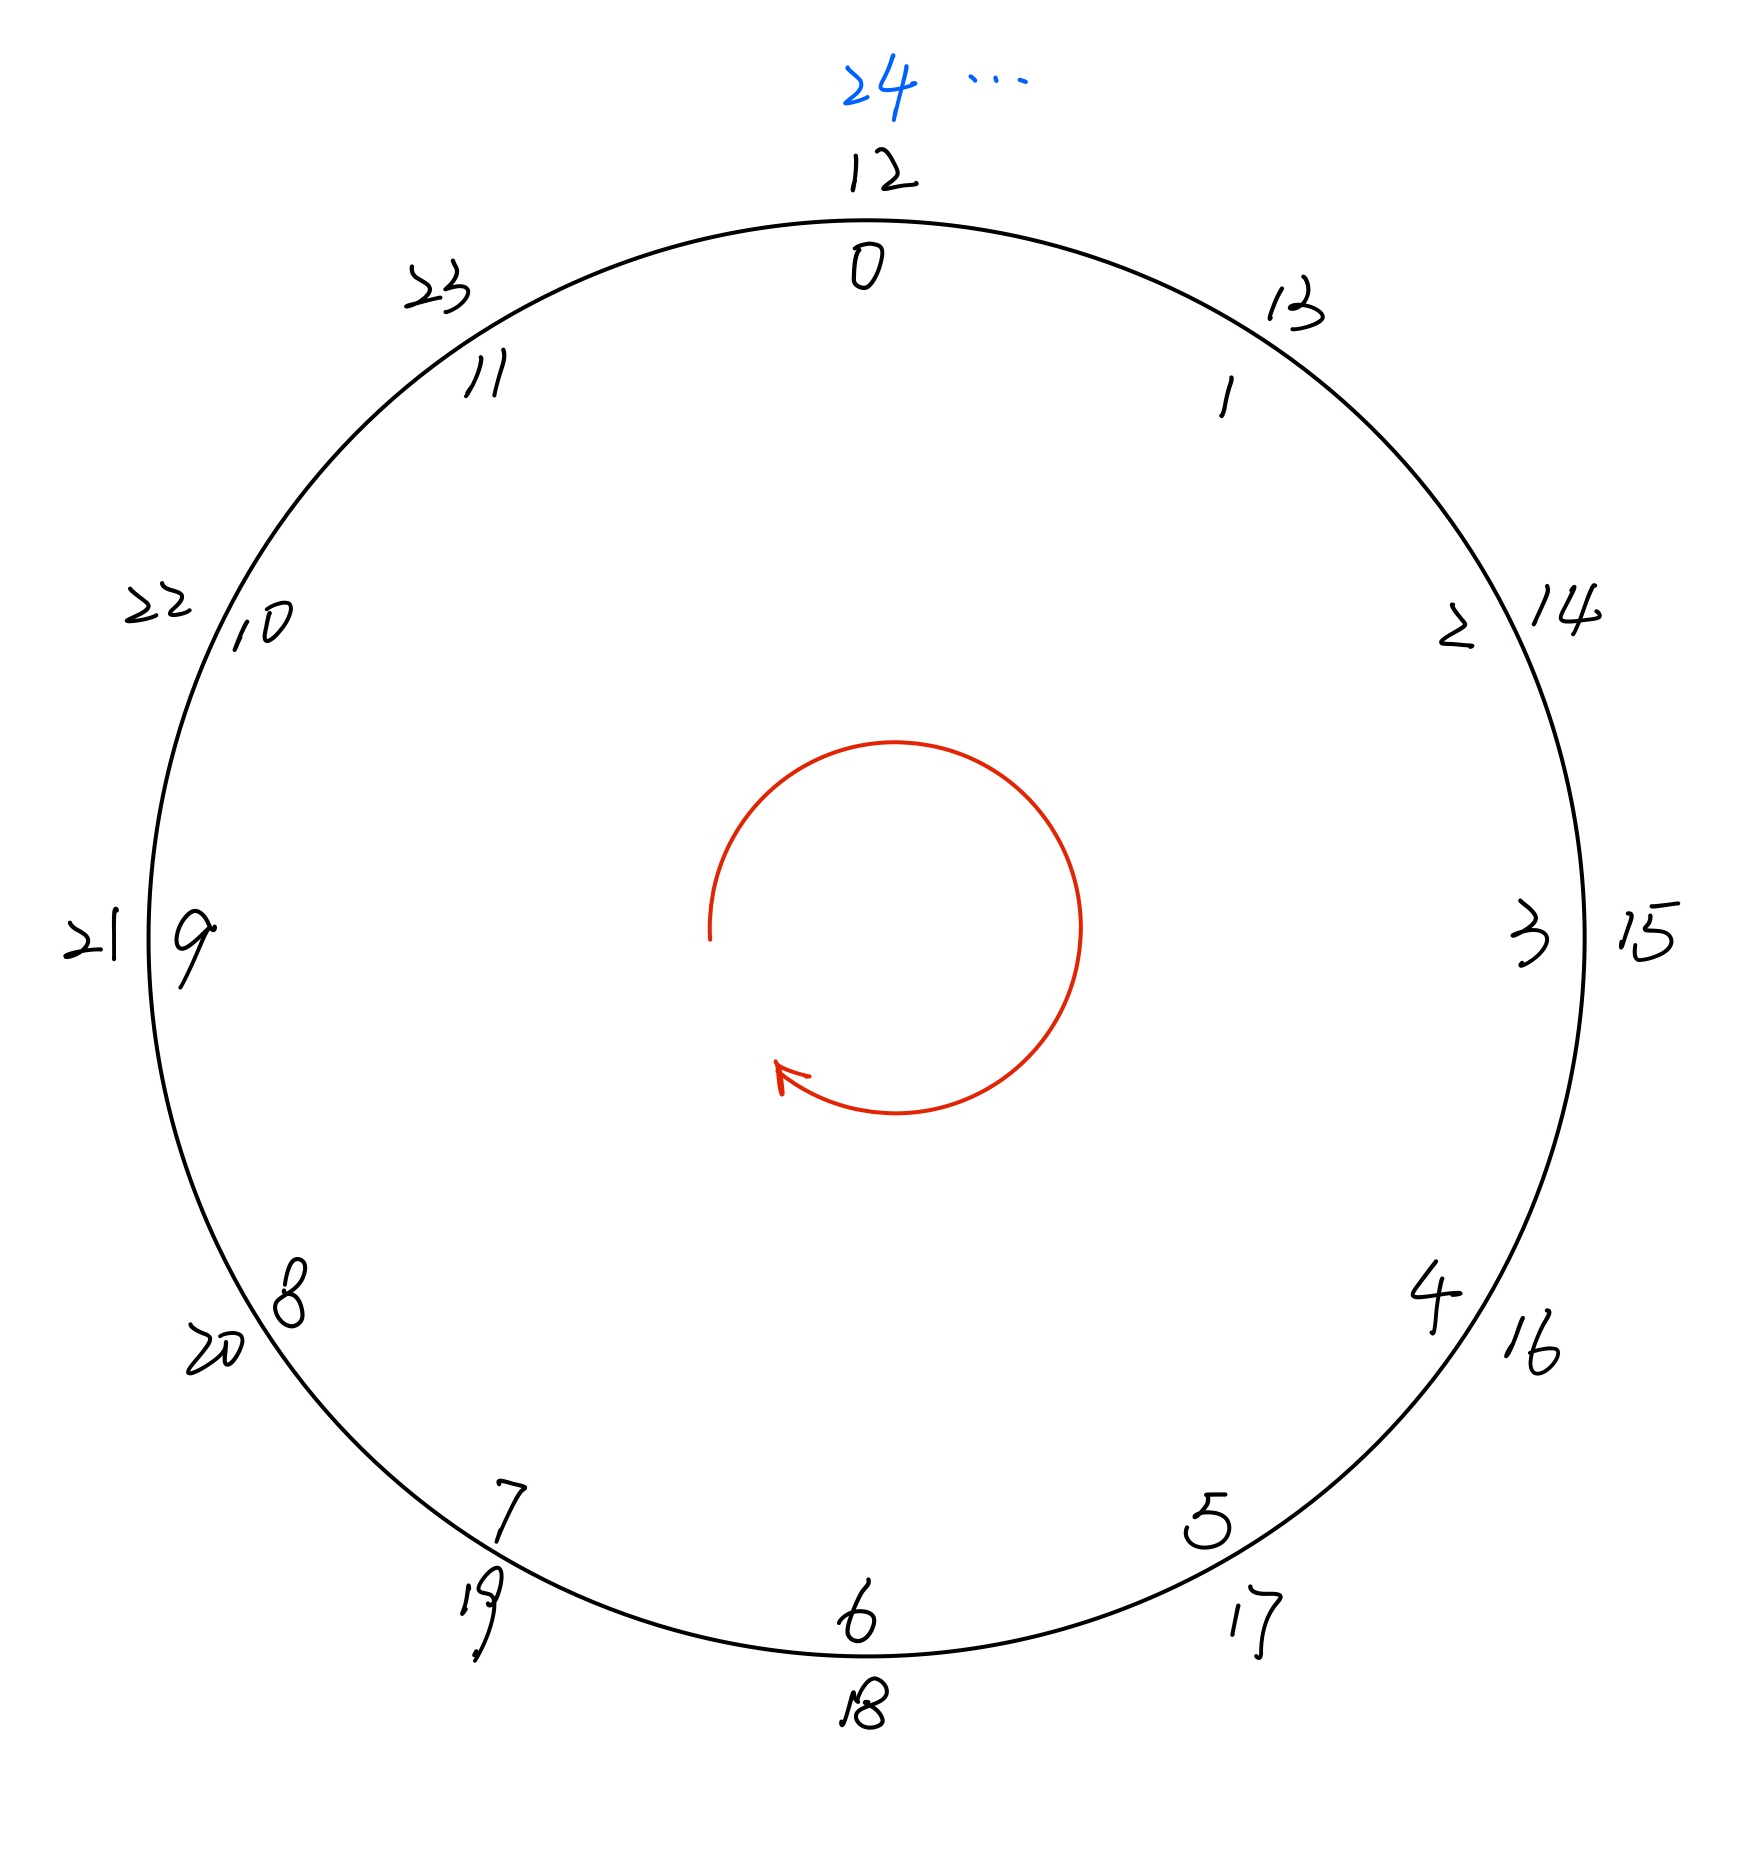
我们以12为模长,那么可以得到如下一个圆环,即0、12、24……是模12等价的。
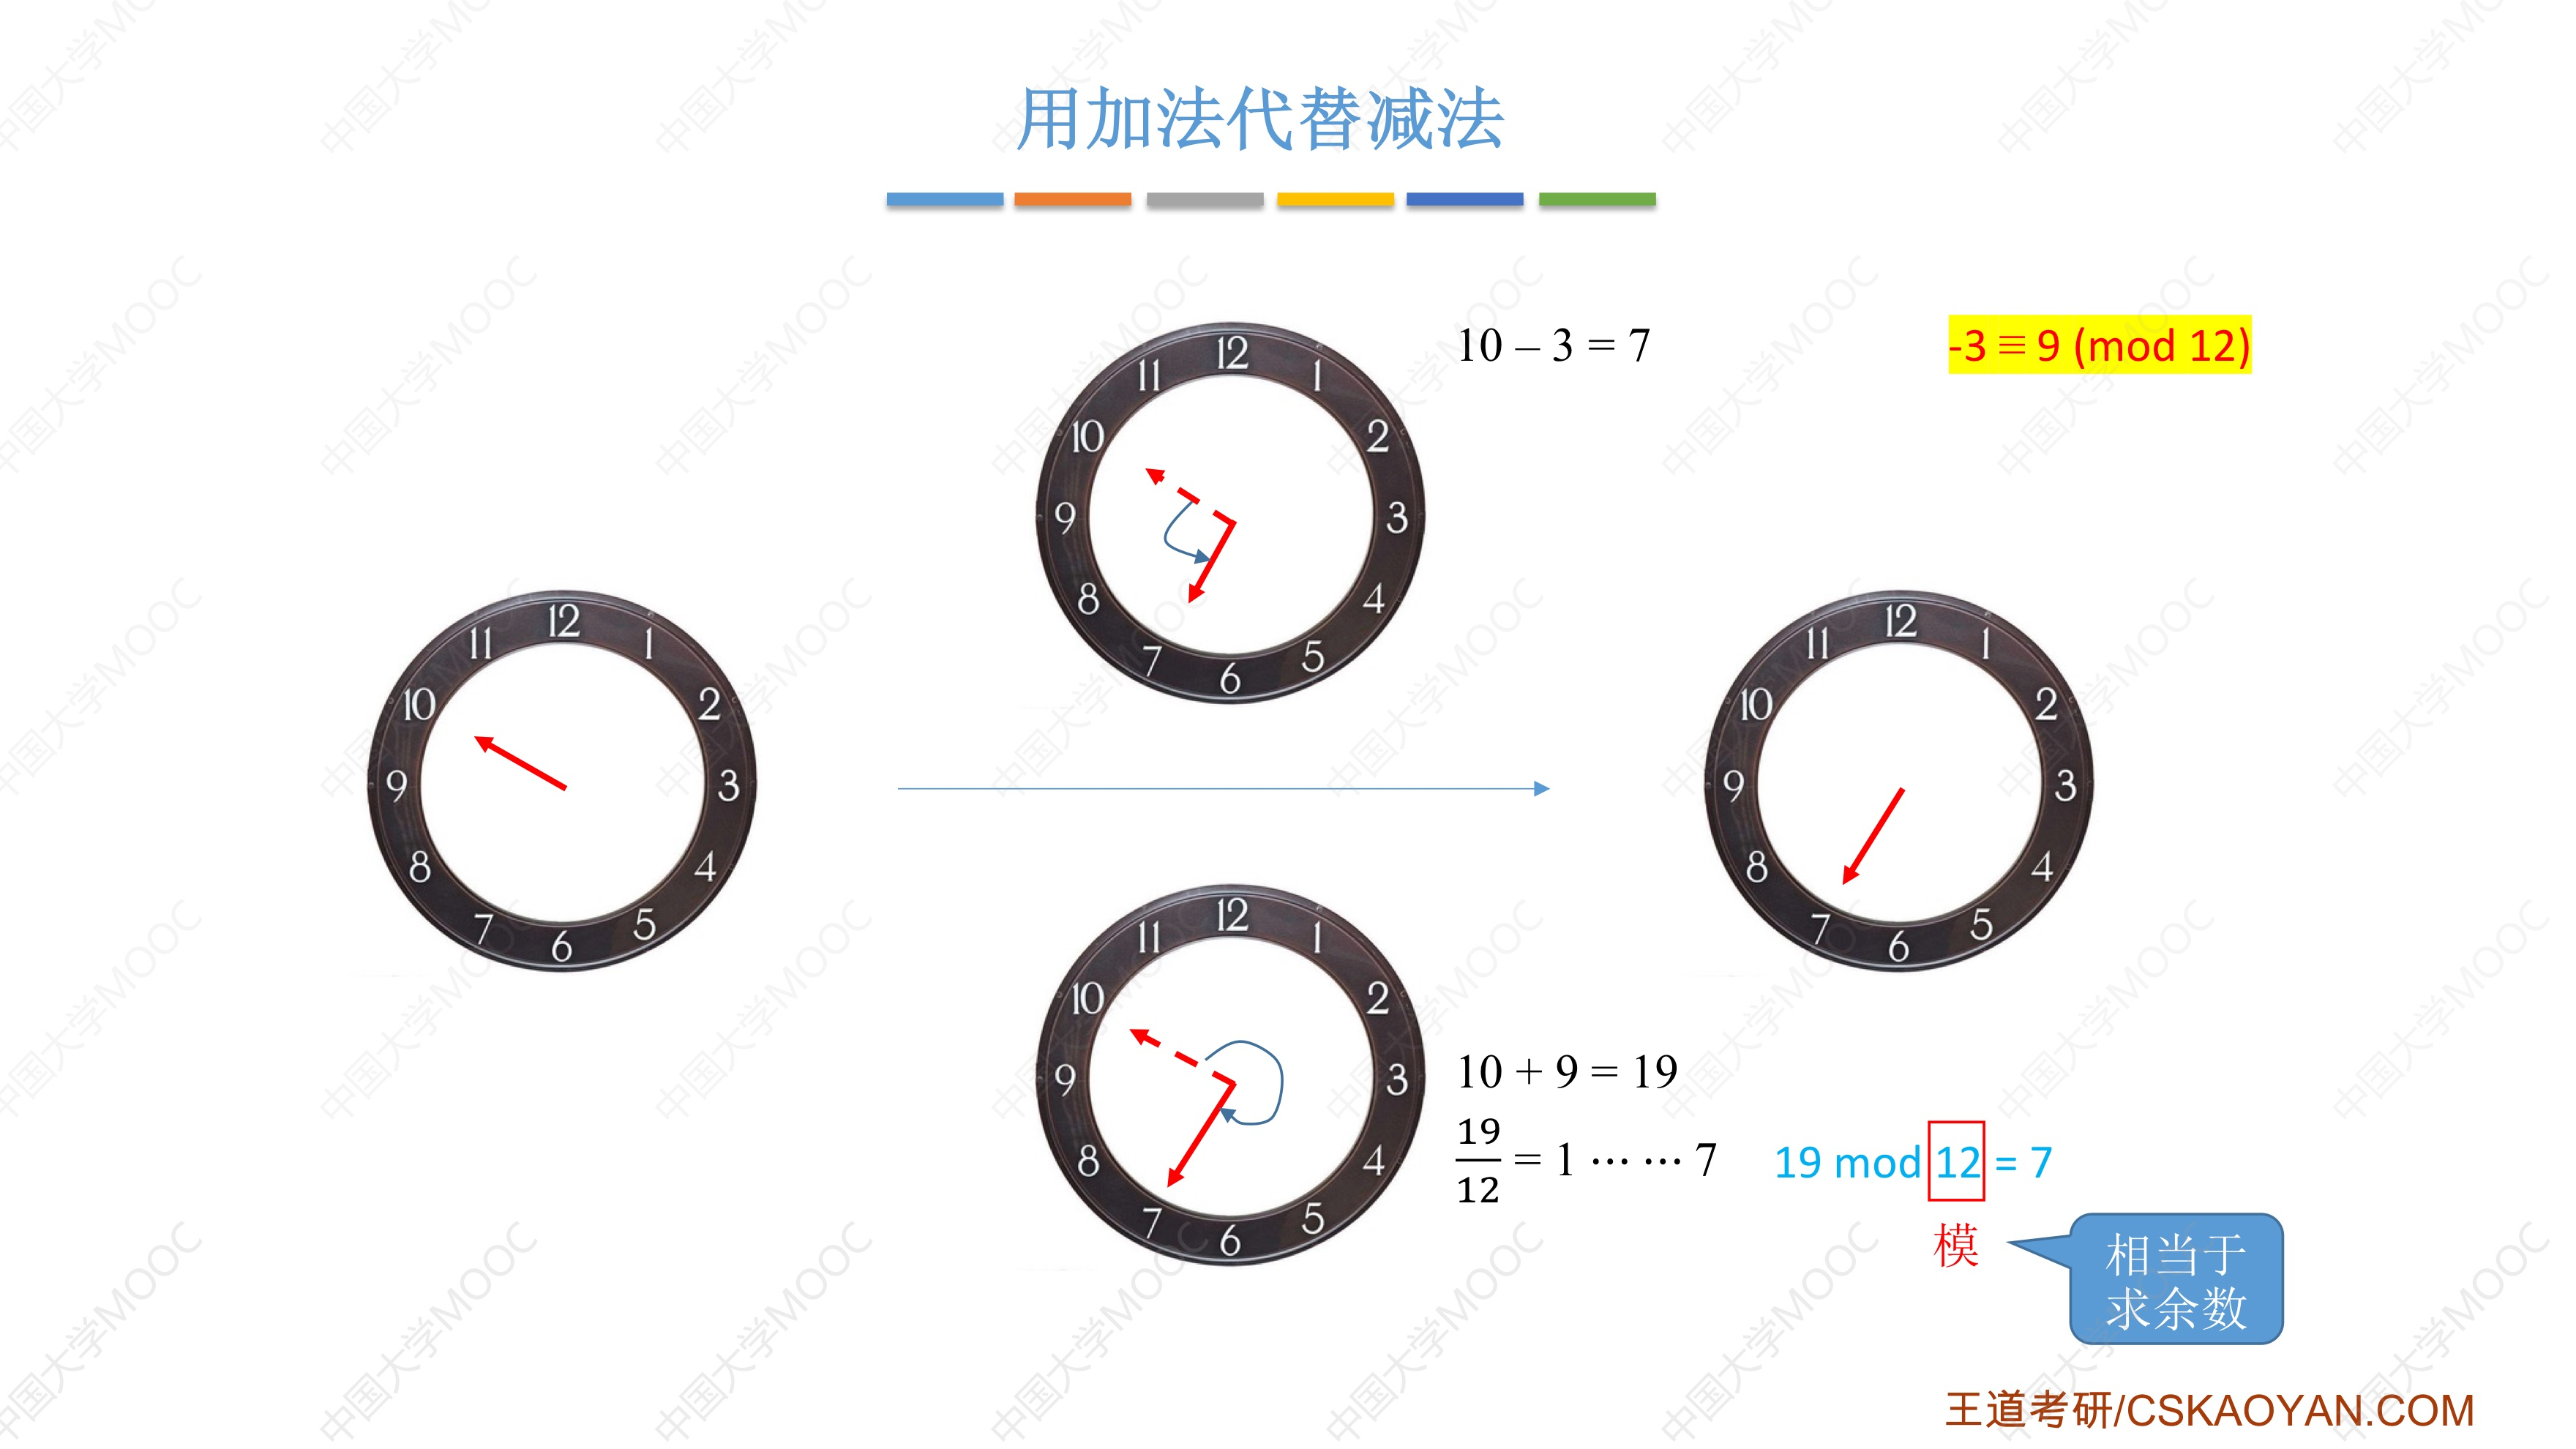
我们现在指针指向的是10,要让指针指向7有两种方法:顺时针(下)转9格和逆时针(上)转3格,如果我们规定顺时针为加法、逆时针为减法,根据模运算的相关定义我们发现,$9\equiv-3(mod\ 12)$,并且两种方法得到的结果相同,因此我们可以将减法转换成加法来进行运算:
小技巧2
补码 定义式如下
补码整数表示范围为$-2^n\le x\le2^n-1$,比原码多表示了$-2^n$,几个特殊数据的补码说明:
- $[+0]补=[-0]补=\underbrace{0,00\dots0}_{n+1个}$,即0的补码唯一
- $[-1]补=2^{n+1}-1=\underbrace{1,11\dots1}{n+1个}$
- $[2^n-1]补=0,\underbrace{11\dots1}{n个}$
- $[-2^n]补=1,\underbrace{00\dots0}{n个}$
变形补码——模4补码 双符号位的补码,用于ALU中判断溢出,00表示正、11表示负,定义式如下
小技巧
补码与真值的转换 正数补码与原码一致,负数对数码”按位取反、末位加一“;一个更加直接的经验:
- 写符号位
- 从右向左抄写数码,直至第一个数码1
- 继续按位取反抄写数码
由$\mathbf{[x]\textbf{补}}$直接求$\mathbf{[-x]\textbf{补}}$ 符号位和数值位均按位取反,末位加一
3.反码
反码在应用上并没有太多实际的意义,它是由原码得到补码的中间产物,即将原码各位取反得到的数码。反码整数的表示范围$-(2^n-1)\le x\le2^n-1$
4.移码
移码是在原码的基础上加了一个偏置值,只用来表示整数,常用来表示浮点数的阶码。定义式如下
- $[+0]移=[-0]移=1,\underbrace{00\dots0}_{n个}$,即0的补码唯一
- $[-2^n]移=\underbrace{0,00\dots0}{n+1个}$
- $[2^n-1]移=\underbrace{1,11\dots1}{n+1个}$
一个真值的移码和补码仅相差一个符号位,即将$\mathbf{[x]\textbf{补}}$的符号位取反为$\mathbf{[x]\textbf{移}}$,反之亦然。移码整数的表示范围$-2^n\le x\le2^n-1$
上面这一条性质意味着:移码和其他编码方式相比,符号位的表示不同——0表示负、1表示正。
编码总结
- 原码、反码、补码的符号位表示相同:0正1负,移码符号为表示相反:0负1正
- 原码、反码的表示范围在数轴上对称,0有正负两种表示
- 补码、移码的表示范围在数轴上不对称,0的表示唯一,在负方向上比原码、反码多表示一个数($-2^n$)
- 原码和移码保持了数据原有的大小顺序,而对于反码和补码可采取以下方式:对于负数,数值位越小,其绝对值越大,即负得越多。
C语言中的数据表示——整数
1’无符号整数&有符号整数
编码无符号位,全部数位均解释为数值位,默认符号位为正。【可以看作最简单的二进制对应关系,是符合我们直觉的对应】
将符号数值化,即我们前面所说的机器数,计算机中采用补码方式表示有符号整数(这里注意审题!)。
2’整型数据类型
无符号 unsigned
有符号 signed
字符型 char,8位,默认为无符号整数,以下其他数据类型默认为有符号整数
短整型 short/ short int,16位
整型 int,32位
长整型 long/long int,在32位机器中是32位、在64位机器中是64位
3’数据类型转换
强制类型转换的本质是改变对编码最高位的解释方式:符号——有符号数、数值——无符号数;C语言标准下,若有符号数和无符号数同时参与运算,按照无符号数处理。
大字长变量转换为小字长变量时,直接截断高位部分;小字长变量转换为大字长变量时要进行高位扩展,需要分情况:
- 无符号数——零扩展:即高位用0填充
- 有符号数——符号扩展:即用符号位填充
【题外话】在实现上其实可以统一为符号扩展,因为无符号数默认为正,或许可以把两种合并到一个代码里实现(只是一个思路,不一定比分开实现好用)。
四、溢出
或者说应该是算术溢出:算术溢出_百度百科 (baidu.com)
核心是超出机器数所能表示的范围。
标志位
- OF:溢出标志,判断有符号数运算结果是否溢出。$OF=Cn\oplus C{n-1}$,符号位和最高数值位进行异或操作,若OF为1,则表示溢出
- SF:符号标志,表示结果的符号,若SF为1,则表示负数;对于无符号数而言,OF和SF没有意义,注意:这不意味着计算机计算的时候这些标志位是空的,而是说它们没有意义,计算机这个笨比是不认识什么是有符号数什么是无符号数的!
- ZF:零标志,判断结果是否为0,若ZF为1,则表示结果为0
- CF:进/借位标志,表示无符号数运算时的进位、借位,用于判断无符号数运算结果是否溢出。$CF=C{in}\oplus C{out}=Sub\oplus C_{out}$,进位输入和输出进行异或操作,若CF为1,则表示溢出
【题外话】不用过分纠结为什么标志位是这样计算的,这是底层电路设计的结果,我们也不一定要抽象出一种数学公式语言去描述运算逻辑,我们只要能够大概理解原理就可以了,我们的描述都是和电路匹配的。(这里的吐槽来自于王道对于定点乘法运算基本原理部分的描述,它的来源是唐朔飞老师的教材,而教材中是以小数为例的,我们如果想直接看他这个总结的数学公式去计算整数乘法的话会发现有些不符合直觉的地方。当然,如果是整数,我们可以把小数点换成逗号看作占位符去做也没问题。)
为什么我说这里的描述是和电路匹配的?
这是两种不同的电路,都可以实现定点乘法运算,显然其逻辑并不完全一致。
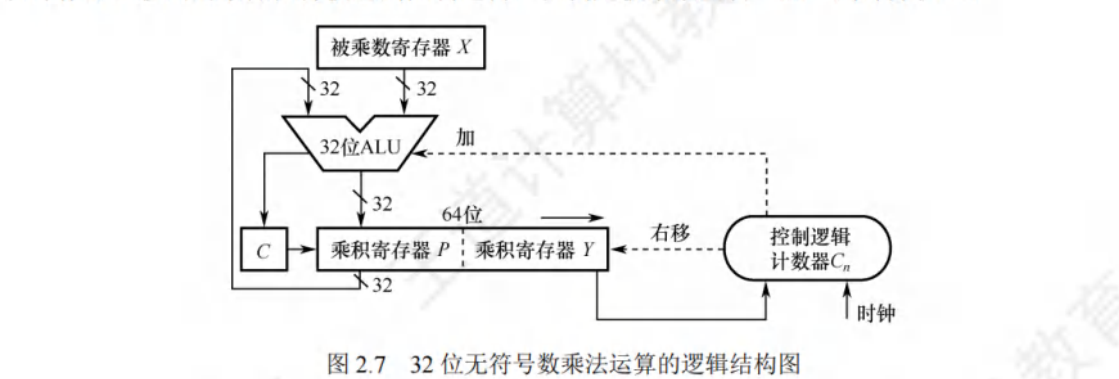
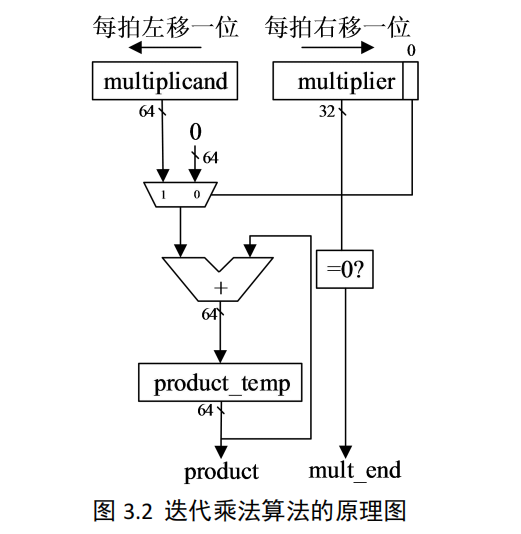
1.溢出判断方法
只有当符号相同的两个数相加或者符号相异的两个数相减时才可能发生溢出。
1’单符号位
其中$A_s、B_s、S_s$分别代表两个操作数和结果的符号位,当$V=0$时,表示无溢出;当$V=1$时,表示溢出。
2’双符号位
根据模4补码的定义,运算结果的两个符号位相同时,无溢出;当运算结果的两个符号位不同时,表示溢出,此时最高位符号位表示真正的符号,可以通过移位运算来弥补溢出。
移位运算
- 算术移位:将操作数视为有符号数
- 左移:高位移出,低位补0,若移出的高位与结果的符号位不同,则溢出
- 右移:低位移出,高位补符号位
- 逻辑移位
- 左移:高位移出,低位补0,若移出的高位是1,则溢出
- 右移:低位移出,高位补0
其中$$S{s_1}、S{s_2}$ $分别双符号位的高位和低位,当$V=0$时,表示无溢出;当$V=1$时,表示溢出。
- $S{s_1}S{s_2}=00$:正数,无溢出
- $S{s_1}S{s_2}=01$:正数,溢出
- $S{s_1}S{s_2}=10$:负数,溢出
- $S{s_1}S{s_2}=11$:负数,无溢出
3’单符号位&进位
其中$Cn、C{n-1}$分别最高位(符号位)进位和次高位(数值位最高位)进位,当$V=0$时,表示无溢出;当$V=1$时,表示溢出。
2.比较大小
1’ 无符号数
判断$A$和$B$的大小,通过减法$A-B$,根据结果的$CF$和$ZF$判断:
- $ZF=1:A=B$
- $ZF=0,CF=0:A>B$
- $ZF=0,CF=1:A<B$
2’ 有符号数
判断$A$和$B$的大小,通过减法$[A]补-[B]补$,根据结果的$OF$、$SF$和$ZF$判断:
- $ZF=1:A=B$
- $ZF=0$
- $OF=0$
- $SF=0:A>B$
- $SF=1:A<B$
- $OF=1$
- $SF=0:A<B$,即负数减正数
- $SF=1:A>B$,即正数减负数
- $OF=0$
五、浮点数的表示与运算
我们过去学习过科学记数法:$a\times10^n$,其中$1\le|a|<10,n\in Z$,这其实就是一种浮点表示法,我们利用有限的空间表示了更大的数。浮点数在位数有限的情况下,既扩大了数的表示范围,又保持了数的有效精度。一般的浮点数表示:
- $S$取0或1,用来决定浮点数的符号
- $M$是定点小数,称为尾数
- $R$是基数
- $E$是定点整数,称为阶码或指数
- 在二进制数据编码中,$R$隐含为2,$M$一般使用原码,$E$一般使用移码
溢出 数据下溢时,浮点数值趋于零,计算机会将其当作机器零处理。
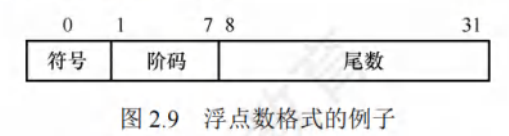
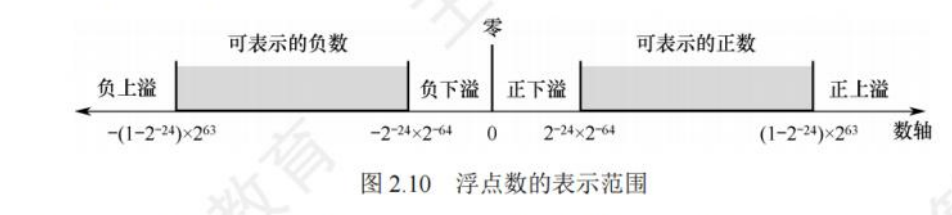
1.规格化
对于以2为基数的原码,当$1/2\le|M|<1$时,我们就称$N=(-1)^S\times M\times R^E$为规格化数:
正数 $0,1\times\dots\times$
最大值 $0,11\dots1=1-2^{-n}$
最小值 $0,10\dots0=\frac{1}{2}$
取值范围 $\frac{1}{2}\le M\le(1-2^{-n})$
负数 $1,1\times\dots\times$
最大值 $1,10\dots0=-\frac{1}{2}$
最小值 $1,11\dots1=-(1-2^{-n})$
取值范围 $-(1-2^{-n})\le M\le-\frac{1}{2}$
左规 当运算结果的尾数的最高数位不是有效位,即$\pm0,0\times\dots\times$,需要进行左规:尾数每左移一位、阶码减一。
右规 当运算结果的尾数有效位进到小数点前时,需要进行右规:尾数右移一位,阶码加一。阶码可能会溢出
2.IEEE 754标准
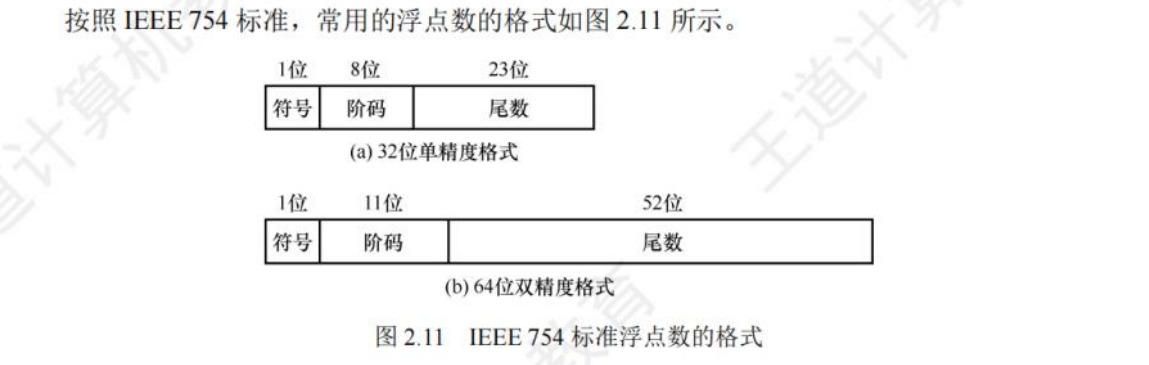
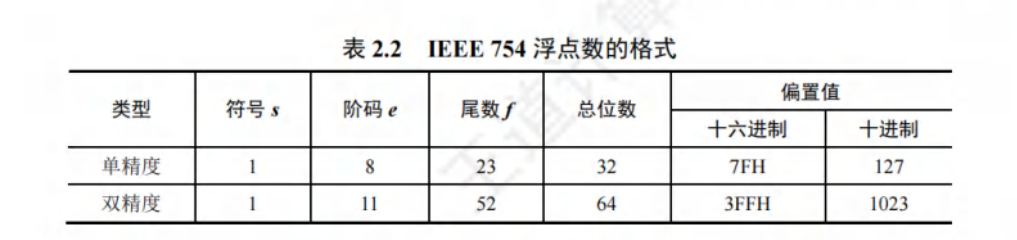
注意:IEEE 754规定规格化的二进制浮点数尾数最高位总是1,作为隐藏位,因此23位尾数实际表示24位有效数字。
- 尾数 原码表示,隐藏位使得浮点数精度更高
- 指数 移码表示,偏置为$2^{n-1}-1$,单精度和双精度偏置分别为127、1023
- 规格化单精度真值 $(-1)^s\times(1+f)\times2^{e-127}$
- 规格化双精度真值 $(-1)^s\times(1+f)\times2^{e-1023}$
IEEE 754 特殊情况
- 全0阶码全0尾数:$+0/-0$
- 全1阶码全0尾数:$+\infty/-\infty$
- 全1阶码非0尾数:NaN
- 全0阶码非0尾数:非规格化数,可以用于处理阶码下溢
3.定点数与浮点数对比
- 数值表示范围:字长相同的情况下,浮点数表示范围大
- 精度:字长相同的情况下,定点数表示精度高
- 溢出问题:浮点数溢出——规格化浮点数阶码溢出时溢出
4.加减运算
对阶$\to$尾数运算$\to$规格化$\to$舍入
对阶:小对大
如果采用大阶码向小阶码看齐的原则,尾数需要左移,那么最高有效位会被移出。
尾数运算:注意还原隐藏位
规格化:规格化数形式$\pm1.\times\dots\times$
- 左规:$\pm0.0\dots01\times\dots\times$
- 右规:$\pm1\times.\times\dots\times$
舍入:
- 就近舍入:0舍1入,恰好位于两个数中间时选择偶数
- 正向舍入
- 负向舍入
- 截断法(趋向于原点的舍入)
5.隐式类型转换
不同类型数混合运算——类型提升
六、字节序和对齐存储
最低有效字节——LSB
最高有效字节——MSB
大端序 LSB存储在存储地址较高的地方
小端序 LSB存储在存储地址较低的地方
以机器数01 23 45 67H为例
1 | 大端序 从左至右地址增高 |
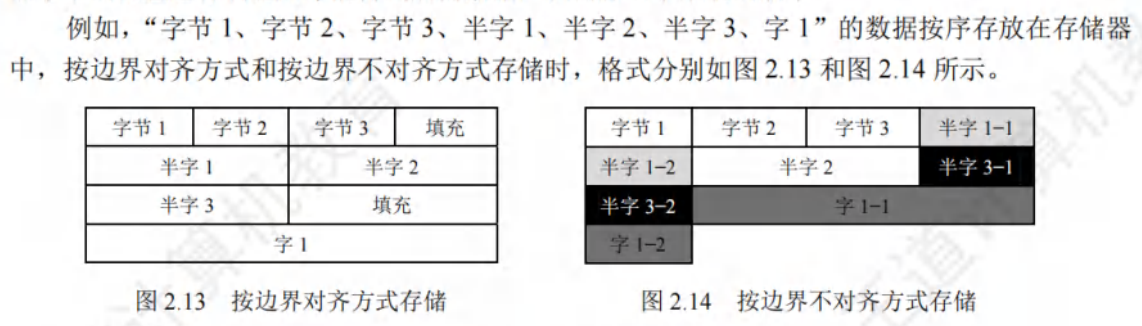
C语言中结构体是小端、边界对齐存储
结构体成员:存储起始地址%成员长度=0
结构体长度为成员最大对齐值的整数倍