一、引言
终于结束了很长的一章,上一章的Cache相关的知识点值得我们再好好思考一番,在这里我再略作补充:
Cache地址——除去标记位的主存地址
二、指令格式
指令是计算机运行的最小功能单位,而一台计算机的所有指令构成该计算机的指令系统,也称为指令集【对于指令集的具体设计是计算机体系结构中的任务——指令集基于体系结构】。指令集体系结构(ISA)完整的定义了软件和硬件之间的接口:
- 指令格式、指令寻址方式、操作类型、操作数
- 操作数类型、操作数寻址方式、大端序or小端序
- 程序可访问的寄存器编号、个数、大小(位数)等
- 存储空间大小、编址方式
- 控制信号
指令,顾名思义就是让谁干什么,用专业的术语来说就是操作码、地址码,基本指令构成如下:
1 | +--------------------+--------------------+ |
操作码 指示指令功能,识别指令、了解指令功能以及区分操作数地址内容的关键信息。
地址码 指示被操作信息(指令或数据)的地址,如:操作数地址、运算结果的保存地址、程序的转移地址、子程序入口地址等。
指令字长 构成指令的二进制数码的位数,与机器字长没有必然联系,一般取存储字长的整数倍。
机器字长 机器硬件设计规定的字长,决定取指令的存取周期;CPU进行一次整数运算能够处理的二进制数据的位数,与ALU之间相关
- 位(Bit):表示一个二进制数码0或1,是计算机存储处理信息的最基本的单位。
- 字节(Byte):一个字节由8个位组成 。
- 字(Word):在X86机器中16个位为一个字(即两个字节是一个字)。
存储字长 一个存储单元存储的二进制数码的位数。
1.按照地址码数目分类
零地址指令 没有显式的地址码;两种可能:(1)无需操作数的指令,如:空操作指令、停机指令、关中断指令等;(2)堆栈计算机中的运算类型指令,其操作数隐式存放在栈顶和次栈顶,运算结果压入栈顶。
一地址指令 与上一种情况类似。
二地址指令 访存次数:取指令1次+取两个操作数2次+写结果1次【共4次】
三地址指令 访存次数:取指令1次+取两个操作数2次+写结果1次【共4次】
四地址指令 访存次数:取指令1次+取两个操作数2次+写结果1次【共4次】值得注意的是,第四个地址一般为下一条指令的地址
2.按照指令长度分类
定长指令字结构
变长指令字结构
3.按照操作码长度分类
定长操作码指令格式
可变长操作码指令格式
小总结 上述两种分类方式,对于定长格式而言,其硬件设计较简单,执行速度较快,但是灵活性差
4.扩展操作码指令格式
可变长操作码的定长指令字结构
- 前缀编码:短码不能是长码的前缀
- 指令操作码不能重复
一般而言,使用频率较高的指令分配较短的操作码,以减少指令译码分析的开销。
5.按照操作类型分类
数据传送 LOAD(源:存储器;目的:寄存器)、STORE(源:寄存器;目的:存储器)
算术和逻辑运算
- 算术:加(ADD)、减(SUB)、乘(MUL)、除(DIV)、自增1(INC)、自减1(DEC)、求补、浮点运算等
- 逻辑:与(AND)、或(OR)、非(NOT)、异或(XOR)、位运算等
移位操作 算术移位、逻辑移位、循环移位
转移操作
- 无条件转移(JMP)
- 条件转移
- JZ:结果为零转移
- JO:结果溢出转移
- JC:结果进位转移
- 调用(CALL)、返回(RET)
- 陷阱(TRAP)
调用和和转移的区别:调用需要保存调用指令下一条指令的地址作为返回地址,待子程序执行结束后跳转到返回地址继续执行主程序。
输入输出操作
三、指令寻址方式
1.指令寻址
关键 程序计数器(PC)
寻址方式 顺序寻址、跳跃寻址
相关概念 指令字长、编址方式
顺序寻址时,程序计数器加“1”,自动形成下一条指令的地址,这里的“1”是带引号的,因为它表示一条指令的指令长度,与编址方式、指令字长相关,指令长度=指令字长/编址长度。跳跃寻址分为两跳跃方式:一种是绝对转移,即地址码直接给出目标地址;另一种是相对转移,即地址码给出的是目标地址相对于当前PC值的偏移量。
2.数据寻址【重点:十种】
1 | +--------------------+--------------------+--------------------+ |
引入两个概念:形式地址(A)和有效地址(EA),形式地址指的是指令中的地址码,而有效地址指的是真实的地址;另外引入一个表示符号(A)表示地址A的内容(数据)
隐含寻址
隐含操作数地址,将某一个操作数由特定的寄存器提供
优点 缩短指令字长
缺点 需要增加硬件(提供操作数或地址)
立即(数)寻址
地址字段直接给出操作数(补码),称该操作数为立即数
优点 指令执行阶段无需访存,指令执行速度最快
缺点 地址码位数限制了立即数的取值范围
直接寻址
地址字段给出的就是有效地址,即$EA=A$
优点 简单,无需计算操作数地址,指令执行阶段访存一次
缺点 地址码位数限制寻址范围
间接寻址
地址字段给出有效地址所在的地址,即$EA=(A)$
优点 扩大寻址范围,现在的寻址范围受限于编址方式,便于编制程序(与程序调用的过程相适应)
缺点 需要多次访存,增加了时间开销(一次间接寻址需要2次访存)
寄存器寻址
地址字段给出的是寄存器的编号,与直接寻址类似,即$EA=R_i$,操作数存放在$R_i$中
优点 指令执行阶段无需访存,只访问寄存器;由于寄存器数量较少,地址码位数较少,指令字长较短
缺点 寄存器成本高
寄存器间接寻址
开始套娃
地址字段给出寄存器编号,寄存器中存储的是操作数的地址,即$EA=((A))=(R_i)$
相比于寄存器寻址,这种方法需要访存;相比于间接寻址,在保留间接寻址扩大寻址范围的基础上,还减少了访存次数
相对寻址
属于偏移寻址类型,借助程序计数器(PC),即$EA=(PC)+A$,此时$PC$中的内容作为基址,地址字段的形式地址$A$作为偏移量,偏移量决定寻址范围
优点 操作数地址随PC值变化(不固定),但是与指令地址之间总是相差一个固定的偏移量,便于程序浮动
适用范围 转移指令
基址寻址
属于偏移寻址类型,借助基址寄存器(BR),即$EA=(BR)+A$,此时$BR$中的内容作为基址,地址字段的形式地址$A$作为偏移量
基址寄存器即OS中的重定位寄存器
优点 扩大寻址范围;用户只需要根据逻辑地址编程而不用关心自己的程序在物理空间上究竟如何存放,因此有利于多道程序设计,编制浮动程序
缺点 偏移量范围有限
注意 面向操作系统,程序员无法修改基址寄存器中的内容,其内容由操作系统或管理程序确定,解决逻辑地址与物理地址的关系问题
变址寻址
属于偏移寻址类型,借助变址寄存器(IX),即$EA=(IX)+A$,此时地址字段的形式地址$A$作为基址,$IX$中的内容作为偏移量
优点 扩大寻址范围;偏移量范围可表示整个存储空间
适用范围 循环程序
注意 面向用户(程序员),用户可以改变变址寄存器中的内容
| 基址寻址 | 变址寻址 | |
|---|---|---|
| 基地址 | 基址寄存器中的内容 | 指令中的地址字段(形式地址) |
| 偏移量 | 指令中的地址字段(形式地址) | 变址寄存器中的内容 |
| 适用范围 | 多道程序、数据分配存储空间 | 数组问题、循环程序 |
| 面向对象 | 操作系统 | 程序员 |
堆栈寻址
- 硬堆栈:借助寄存器
- 软堆栈:主存中开辟一段地址空间
堆栈指针(SP):指示栈顶元素的地址
数据寻址总结
| 寻址方式 | 有效地址 | 访存次数 | 适用情况 |
|---|---|---|---|
| 隐含寻址 | 0 | ||
| 直接寻址 | $EA=A$ | 1 | 相对于立即寻址缩短了指令长度(对于超长数据而言) |
| 立即(数)寻址 | $A$就是操作数本身 | 0 | 寄存器赋初值 |
| 一次间接寻址 | $EA=(A)$ | 2 | 扩大了寻址范围,易于完成子程序返回 |
| 寄存器寻址 | $EA=R_i$ | 0 | 指令字较短,指令执行速度较快 |
| 寄存器一次间接寻址 | $EA=((A))=(R_i)$ | 1 | 扩大寻址范围并相对于间接寻址减少访存次数 |
| 相对寻址 | $EA=(PC)+A$ | 1 | 控制程序执行顺序、转移 |
| 基址寻址 | $EA=(BR)+A$ | 1 | 对比变址寻址 |
| 变址寻址 | $EA=A+(IX)$ | 1 | 对比基址寻址 |
| 堆栈寻址 | 硬堆栈:0;软堆栈:1 |
四、机器级代码——汇编
X86汇编指令
向后兼容
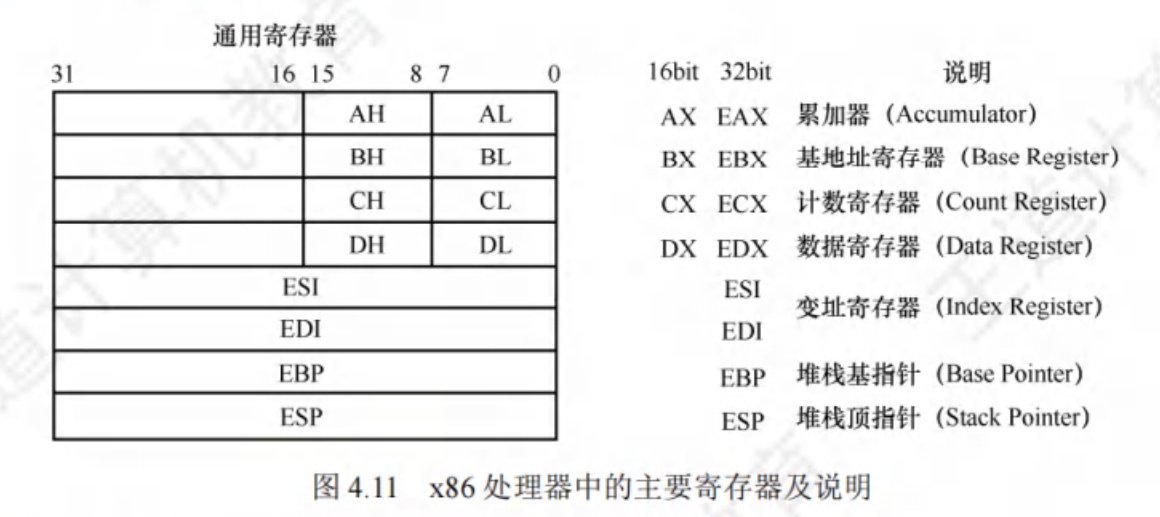
X表示一种未知代号,也就是说前四个为通用寄存器,中间两个为变址寄存器(I=Index,S=Source,D=Destination)EBP和ESP分别为堆栈基指针、堆栈顶指针。
| AT&T格式 | Intel格式 |
|---|---|
| 指令字母小写 | 指令字母大写 |
| 源操作数在左,目的操作数在右 | 源操作数在左,目的操作数在左 |
| 寄存器和立即数的前缀:“%”、“$” | 无前缀 |
| 内存寻址圆括号——“(”、“)” | 内存寻址方括号——“[”、“]” |
| 复杂寻址:偏移量(基址寄存器,变址寄存器,比例因子) | 复杂寻址:[基址寄存器+变址寄存器*比例因子+偏移量] |
| 数据长度后缀:b-byte-8;w-word-16;l-long-32 | 数据长度显式注明:数据长度+ptr |
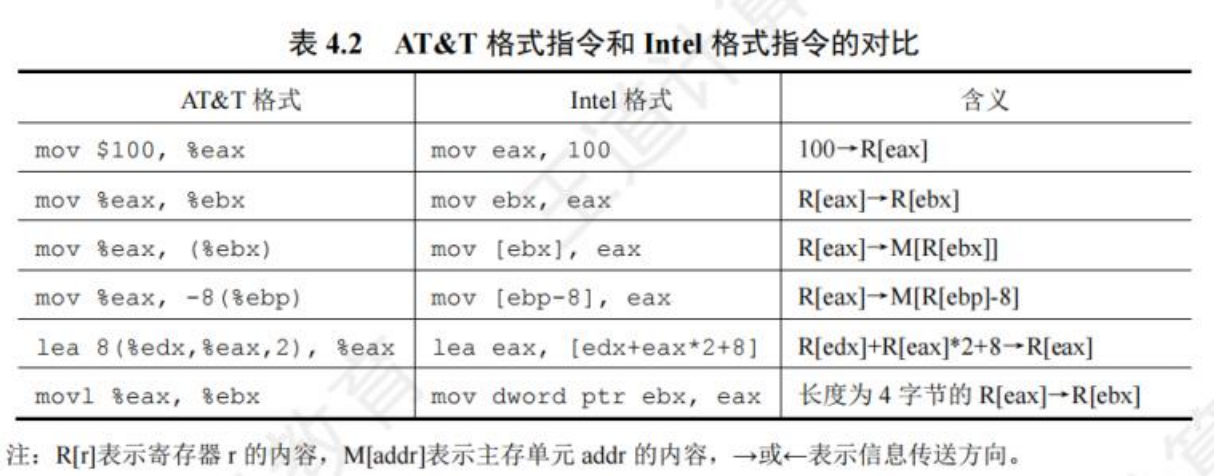
注意:
- 双操作数的指令不能都是内存,mov指令不能直接从内存复制到内存
- 栈增长方向与内存地址增长方向相反
- 除法指令用到了隐含寻址,被除数在EDX:EAX中,商存在EAX,余数存在EDX
- 在X86架构中,程序计数器PC(Program Counter)被称为IP寄存器(Instruction Pointer)
- 转移指令同样使用标号锚定目标位置,有条件转移通常需要先执行比较指令
- 函数的起始地址通常用函数名作为标号
- 循环语句:条件转移指令或loop指令(ECX作为循环计数器,循环时自减,默认当ECX!=0的时候回到循环标记)
函数调用
函数调用栈
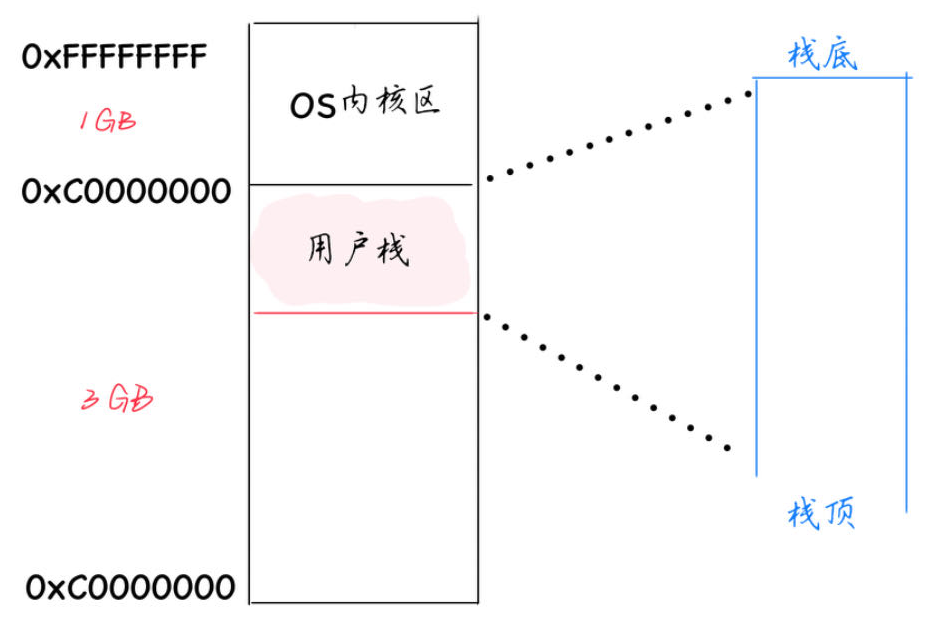
X86系统中,默认以4字节作为栈的操作单位
访问栈帧
push、pop指令——操作栈顶:push让栈顶指针ESP减4(字节),然后将数据压入栈;pop将数据弹出栈并写入pop后的地址中,然后让栈顶指针加4(字节)
mov指令——更为通用的移动操作,结合add和sub指令修改ESP的值
切换栈帧
个人建议画图分析
1
2
push ebp #保存旧栈帧的栈底指针
mov ebp,esp #设置新栈帧的栈底指针1
2mov esp,ebp #取出旧栈帧的栈底指针
pop ebp #恢复旧栈帧的栈底指针函数的栈帧(Stack Frame):保存函数的局部变量和函数调用的相关信息
- 栈帧的最底部——上一层栈帧的基址EBP旧值
- 栈帧的最顶部——返回地址
- 栈帧底部的区域——局部变量:越接近底部的变量其定义时间越晚;借助EBP访问
- 栈帧顶部的区域——参数:越接近顶部的参数其位置在参数列表中越靠前;借助ESP访问
GCC编译器会将每个栈帧大小设置为16B的整数倍。
call指令和ret指令分别为调用指令和返回指令
- call指令:将IP(PC)的旧值压栈保存(在函数栈帧的顶部);设置IP(PC)新值,无条件跳转至被调用函数的第一条指令
- ret指令:从函数栈帧的顶部返回旧的IP(PC)值,即使其出栈并恢复IP寄存器(PC)
五、CISC&RISC
| CISC | RISC | |
|---|---|---|
| 名称 | Complex Instruction Set Computer;复杂指令集计算机 | Reduced Instruction Set Computer;精简指令集计算机 |
| 设计思想 | 一个功能由一条指令完成 | 一个功能由多条基本指令完成 |
| 指令系统 | 复杂,庞大 | 简单,精简 |
| 指令数目 | 一般大于200条 | 一般小于100条 |
| 指令字长 | 不固定,指令格式多,寻址方式多 | 定长 |
| 可访存指令 | 不受限制 | LOAD、STORE【其余指令均在寄存器间进行】 |
| 指令执行时间 | 相差很大,大多数指令需要多个时钟周期 | 绝大多数指令在一个时钟周期内完成 |
| 指令使用频度 | 相差很大 | - |
| 通用寄存器数量 | 较少 | 多 |
| 目标代码 | 难以用优化编译生成高效的目标代码程序 | 可以进行编译优化 |
| 控制方式 | 微程序 | 组合逻辑(硬布线) |
| 指令流水线 | 可通过一定的方式实现 | 必须满足流水线技术 |
| 代表架构 | X86 | ARM、MIPS |